Konfidenzgrenzen: Ihre Rolle bei der Datenanalyse verstehen
Sie erfahren, welche entscheidende Rolle Konfidenzgrenzen bei der Verbesserung der Genauigkeit statistischer Schlussfolgerungen spielen.
Einführung
In statistical analysis, Grenzen des Selbstvertrauensentscheidende numerische Grenzen dar, die den geschätzten Bereich eines Parameters mit einer bestimmten Sicherheit festlegen. Diese Grenzen bilden die Grundlage für unser Verständnis der Datenvariabilität und unterstützen Entscheidungsträger durch eine probabilistische Bewertung der Zuverlässigkeit und Präzision ihrer Interpretationen. Dieser Artikel legt das Konzept derGrenzen des Selbstvertrauensumfassend dar und bietet Lesern eine Basis, um deren unverzichtbare Rolle bei der Auswertung komplexer datenbasierter Erkenntnisse und fundierter Entscheidungen zu verstehen. Durch eine detaillierte Untersuchung derGrenzen des Selbstvertrauensmöchten wir die analytischen Fähigkeiten verbessern, die für die Navigation im komplexen Feld der statistischen Inferenz notwendig sind, und damit das Engagement für die Aufdeckung der Richtigkeit und Tiefe von Datenanalyse practices.
Highlights
- Konfidenzgrenzen beschreiben den Bereich, in dem ein Populationsparameter mit einer bestimmten Wahrscheinlichkeit liegt.
- Stichprobengröße und Varianz wirken sich direkt auf die Breite der Konfidenzgrenzen aus und wirken sich auf die statistische Präzision aus.
- Durch die Unterscheidung von Konfidenzgrenzen und Vorhersageintervallen werden ihre einzigartigen Anwendungen in der Analyse verdeutlicht.
- Fortschrittliche Tools wie R und Python bieten robuste Methoden zur effizienten Berechnung von Konfidenzgrenzen.
- Die korrekte Interpretation von Konfidenzgrenzen ist entscheidend, um in Forschungsstudien verlässliche Schlussfolgerungen ziehen zu können.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Vertrauen begrenzt theoretische Grundlagen
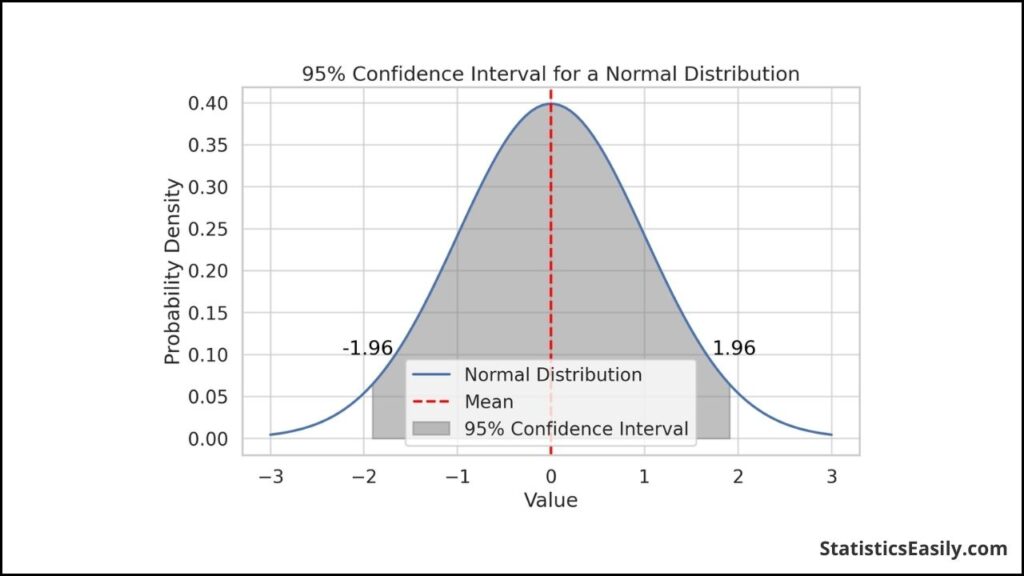
Bei der UntersuchungGrenzen des Selbstvertrauenssteht ein grundlegendes Konzept im Zentrum der statistischen Inferenz:Konfidenzintervalle. Diese Intervalle stellen Bereiche dar, die anhand von Stichprobendaten geschätzt werden und in denen ein Populationsparameter (z. B. Mittelwert, Anteil) mit einer bestimmten Wahrscheinlichkeit – typischerweise 95 % oder 99 % – liegt. DieGrenzen des Selbstvertrauens– die obere und untere Grenze dieser Intervalle – dienen als wichtige Abgrenzungen und umfassen den Bereich plausibler Werte für den betreffenden Parameter.
Bei der Betrachtung der theoretischen Grundlagen stoßen wir auf grundlegende Konzepte wie Populationsparameter und Stichprobenstatistik. Populationsparameter beschreiben die wahren Werte, die wir durch unsere Analyse schätzen möchten. Stichprobenstatistik hingegen sind die aus unseren erhobenen Daten abgeleiteten Schätzwerte. Die Verbindung zwischen diesen beiden Bereichen wird durch denzentralen Grenzwertsatzhergestellt . Dieser besagt, dass sich die Verteilung des Stichprobenmittelwerts bei ausreichend großem Stichprobenumfang einer Normalverteilung annähert, unabhängig von der Verteilung der Grundgesamtheit. Dieser Satz bildet die Grundlage für die Berechnung vonKonfidenzintervalleund damit auchGrenzen des Selbstvertrauensund ermöglicht deren Anwendung selbst dann, wenn die Verteilung der Grundgesamtheit unbekannt ist.
Die UnterscheidungGrenzen des Selbstvertrauensund Prognoseintervallen ist für deren korrekte Anwendung unerlässlich. WährendGrenzen des Selbstvertrauensdie Unsicherheit um die Schätzung eines Populationsparameters beschreiben, umfassen Prognoseintervalle die Unsicherheit um einzelne Beobachtungen. Diese Unterscheidung ist entscheidend, da sie die jeweilige Anwendung verdeutlicht:Grenzen des Selbstvertrauensdienen der Parameterschätzung, Prognoseintervalle der Vorhersage individueller Ergebnisse.
Wir stärken unseren statistischen Scharfsinn und schärfen unsere analytische Präzision, indem wir unser Verständnis auf diesen theoretischen Grundlagen aufbauen. Diese Klarheit in der Datenanalyse ermöglicht es uns, durch komplexe Datensätze zu navigieren und aussagekräftige Erkenntnisse zu gewinnen, was unser Streben nach Wahrheit vorantreibt und zu fundierten Entscheidungsprozessen beiträgt.
Berechnung von Konfidenzgrenzen
Die BerechnungGrenzen des Selbstvertrauensist in der statistischen Analyse von zentraler Bedeutung. Sie liefert einen quantifizierbaren Bereich, innerhalb dessen der wahre Populationsparameter auf Basis von Stichprobendaten vermutet wird. Dieser Berechnung liegen spezifische Verteilungen zugrunde – üblicherweise die Normalverteilung für große Stichproben und die t-Verteilung für kleinere Stichproben oder wenn die Standardabweichung der Population unbekannt ist.
Einfluss von Stichprobengröße, Varianz und Konfidenzniveau
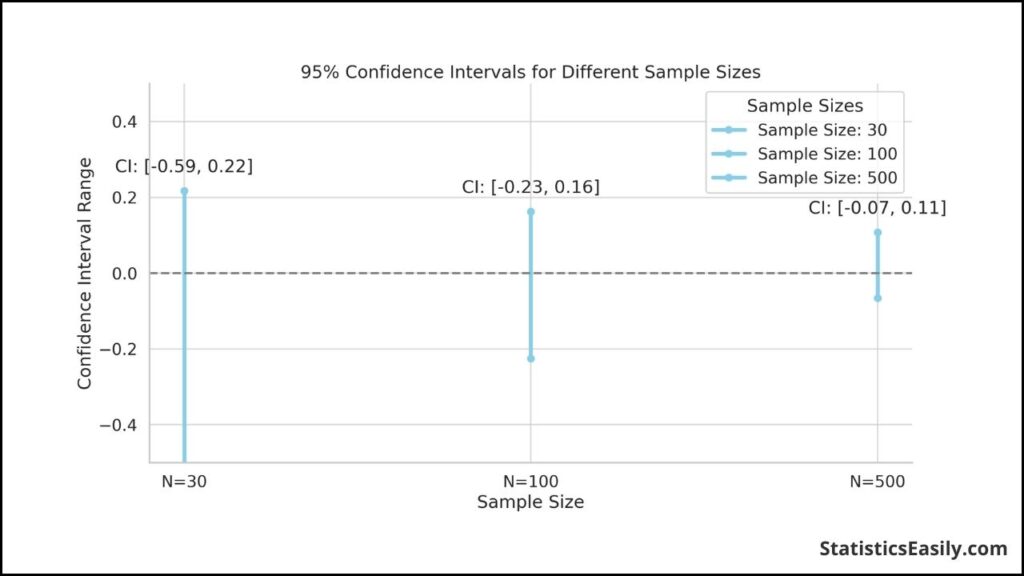
Die Stichprobengröße, die Varianz und das gewählte Konfidenzniveau beeinflussen die Präzision der Grenzen des Selbstvertrauensmaßgeblich . Eine größere Stichprobe verringert den Standardfehler, was zu engeren Grenzen des Selbstvertrauens und somit zu einer präziseren Schätzung des Populationsparameters führt. Umgekehrt erweitert eine höhere Varianz innerhalb der Stichprobendaten die Grenzen des Selbstvertrauensund spiegelt eine erhöhte Unsicherheit in der Schätzung wider. Auch das Konfidenzniveau, typischerweise auf 95 % oder 99 % festgelegt, spielt eine entscheidende Rolle: Ein höheres Konfidenzniveau erweitert die Grenzen des Selbstvertrauensund berücksichtigt eine größere Unsicherheit, um sicherzustellen, dass das Intervall den wahren Parameter mit dem gewünschten Konfidenzniveau umfasst.
Softwaretools für Berechnungen
In der modernen Datenanalyse sind Softwaretools und Programmiersprachen wie R und Python unverzichtbar, umGrenzen des Selbstvertrauenseffizient zu berechnen . Diese Tools bieten integrierte Funktionen, die komplexe Berechnungen automatisieren und so ihre Anwendung auf unterschiedlichste Datensätze und Forschungsszenarien erleichtern.
- In R, Funktionen wie „t.test“ für Mittelwerte oder „prop.test“ für Proportionen können verwendet werden, wobei dieGrenzen des Selbstvertrauenssind Teil der Ausgabe.
- Pythonstellt mit Bibliotheken wie SciPy und StatsModels Funktionen wie „scipy.stats.t.interval“ zur Berechnung bereitGrenzen des SelbstvertrauensBasierend auf der T-Verteilung, um unterschiedlichen Datenanalyseanforderungen gerecht zu werden.
Der Einsatz dieser Tools rationalisiert nicht nur den Berechnungsprozess, sondern verbessert auch die Zugänglichkeit statistischer Analysen, sodass sich Forscher und Analysten stärker auf die Interpretation und Anwendung der Ergebnisse konzentrieren können.
Interpretation von Vertrauensgrenzen
Die InterpretationGrenzen des Selbstvertrauensin Forschung und Datenanalyse erfordert ein differenziertes Verständnis, um häufige Missverständnisse und damit verbundene Fehlinterpretationen der Ergebnisse zu vermeiden. Diese Grenzen, die den Bereich abgrenzen, in dem wir einen Populationsparameter schätzen, liefern ein Maß für statistische Sicherheit, werden aber oft missverstanden.
Ein weit verbreiteter Irrglaube ist die Annahme, dass einKonfidenzintervall, das den Wert eines Parameters der Nullhypothese enthält (wie beispielsweise Null bei einem Mittelwerttest), direkt bedeutet, dass die Nullhypothese nicht verworfen werden kann. Diese Interpretation übersieht, dassKonfidenzintervalleauf Stichprobendaten basieren und der Stichprobenvariabilität unterliegen. Sie bieten einen Bereich plausibler Werte für den Parameter, aber keinen definitiven Test der Hypothese.
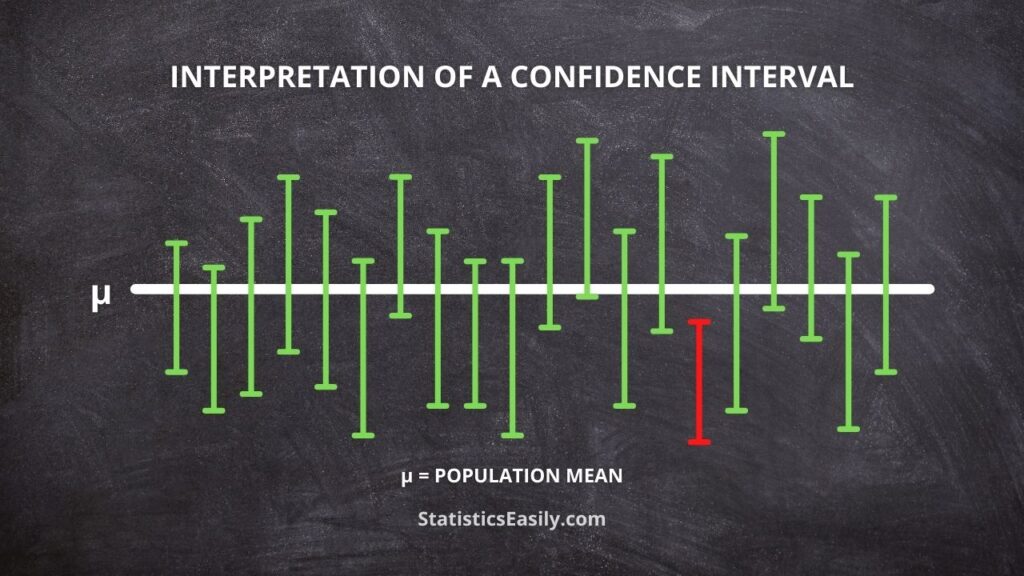
Darüber hinaus besteht eine häufige Fehlerquelle darin, anzunehmen, dass dasKonfidenzintervalldie Wahrscheinlichkeit darstellt, dass der wahre Parameter innerhalb des Intervalls liegt.
Die korrekte Interpretation lautet: Würde man die Studie mehrmals wiederholen, würden 95 % (bei einem Konfidenzniveau von 95 %) der berechneten Konfidenzintervalle aus diesen Studien den wahren Parameter enthalten.
Beispiel aus der Praxis: Medizinische Forschung
In einer medizinischen Studie zur Wirksamkeit eines neuen Medikaments könnten dieGrenzen des Selbstvertrauensdarauf hindeuten, dass das Medikament die durchschnittliche Genesungszeit der Patienten um 2 bis 5 Tage verkürzt (bei einem Konfidenzniveau von 95 %). Eine Fehlinterpretation entsteht, wenn man daraus schließt, dass die tatsächliche durchschnittliche Verbesserung mit 95%iger Wahrscheinlichkeit innerhalb dieses Intervalls liegt. Korrekterweise bedeutet dies, dass wir mit 95%iger Wahrscheinlichkeit davon ausgehen können, dass dieses Intervall die tatsächliche mittlere Verbesserung erfasst. Diese Unterscheidung unterstreicht die Zuverlässigkeit der Schlussfolgerung und stellt keine Wahrscheinlichkeitsaussage über den Parameter dar.
Beispiel aus der Praxis: Umweltwissenschaften
Betrachten wir eine Umweltstudie, die den Rückgang der Schadstoffbelastung nach Einführung einer Luftreinhaltepolitik schätzt. DieGrenzen des Selbstvertrauensdeuten auf eine Reduktion von 10 bis 15 Mikrogramm pro Kubikmeter hin. Ein häufiger Fehler besteht darin, diese Intervalle als Wahrscheinlichkeitsbereich für die Schadstoffreduktion zu interpretieren. Sie sollten vielmehr als der Bereich verstanden werden, in dem wir – basierend auf unserer Stichprobe – mit hoher Wahrscheinlichkeit davon ausgehen, dass die tatsächliche durchschnittliche Reduktion in der Gesamtbevölkerung liegt, sollte die Studie unter identischen Bedingungen wiederholt werden.
Vertrauensgrenzen in verschiedenen Disziplinen
Die Anwendung vonGrenzen des Selbstvertrauensgeht über die reine Statistik hinaus und findet in verschiedenen Disziplinen Anwendung, in denen datengestützte Entscheidungen von zentraler Bedeutung sind. Diese Disziplinen nutzenGrenzen des Selbstvertrauens, um Unsicherheiten zu quantifizieren, Forschungsmethoden zu steuern und politische Entscheidungen zu untermauern.
Medizin
In der Medizin spielen Grenzen des Selbstvertrauens eine entscheidende Rolle bei der Bewertung der Wirksamkeit und Sicherheit neuer Therapien. Beispielsweise könnte eine klinische Studie zur Wirksamkeit eines neuen Medikaments eine Reduktion der Symptomstärke berichten, wobei die Konfidenzintervalle den Bereich dieser Reduktion angeben. Dieser Bereich ist für medizinisches Fachpersonal unerlässlich, um den potenziellen Nutzen und die Risiken der Behandlung abzuschätzen und so klinische Leitlinien und Strategien für die Patientenversorgung zu entwickeln.
Umweltwissenschaften
Umweltwissenschaftler nutzen Grenzen des Selbstvertrauens um die Auswirkungen von Maßnahmen auf Schadstoffbelastung, Biodiversität und Klimamodelle zu bewerten. Eine Studie zu den Effekten einer Schadstoffreduktionspolitik könnte diese Intervalle verwenden, um die geschätzte Veränderung der Schadstoffbelastung darzustellen und so Aufschluss über die Wirksamkeit der Politik zu geben und zukünftige Umweltvorschriften zu lenken.
Wirtschaftskunde
In der Wirtschaftswissenschaft spielen Grenzen des Selbstvertrauens eine zentrale Rolle bei der Prognose von Wirtschaftsindikatoren wie BIP-Wachstum, Inflationsrate und Arbeitslosigkeit. Beispielsweise kann eine Wirtschaftsprognose das BIP-Wachstum innerhalb dieser Grenzen vorhersagen und politischen Entscheidungsträgern und Unternehmen so einen Rahmen aufzeigen, in dem die tatsächliche Wachstumsrate voraussichtlich liegen wird. Dies unterstützt die Finanzplanung und die Politikgestaltung.
Fallstudie: Öffentliche Gesundheitspolitik
Ein bemerkenswertes Beispiel, bei dem Grenzen des Selbstvertrauens eine entscheidende Rolle spielten, war eine Studie im Bereich der öffentlichen Gesundheit, die die Auswirkungen eines Rauchverbots auf die Herzinfarktrate untersuchte. Die Studie berichtete von einem signifikanten Rückgang der Herzinfarkt-Einweisungen nach Inkrafttreten des Verbots, wobei die Konfidenzintervalle einen präzisen Bereich für diesen Rückgang vorgaben. Diese Ergebnisse beeinflussten die Gesundheitspolitik und führten zur weitverbreiteten Einführung von Rauchverboten in öffentlichen Bereichen, um die Gesundheit der Bevölkerung zu verbessern.
Fallstudie: Umweltschutz
Ein weiteres anschauliches Beispiel stammt aus der Naturschutzbiologie. Dort nutzten Forscher Grenzen des Selbstvertrauens , um die Populationsgröße einer gefährdeten Art in einem Schutzgebiet zu schätzen. Diese Intervalle lieferten einen Rahmen für die Schätzung der Populationsgröße und dienten als Grundlage für Naturschutzmaßnahmen und die Ressourcenverteilung, um das Überleben der Art zu sichern.
Fortgeschrittene Themen und Kontroversen
Nichtparametrische Konfidenzintervalle
Nichtparametrische Konfidenzintervalle bieten eine Lösung, wenn die Daten nicht den Annahmen standardmäßiger parametrischer Tests, wie etwa der Normalität, entsprechen. Techniken wie Bootstrapping, bei dem die Daten erneut abgetastet und ersetzt werden, bieten eine Möglichkeit, Konfidenzintervalle zu schätzen, ohne sich auf bestimmte Verteilungsannahmen zu verlassen. Diese Flexibilität macht nichtparametrische Methoden bei der Verarbeitung von Daten mit unbekannten oder nicht-normalen Verteilungen von unschätzbarem Wert, wenn auch oft auf Kosten einer erhöhten Rechenkomplexität.
Bayesianische Konfidenzintervalle
Bayesianische Konfidenz- oder Glaubwürdigkeitsintervalle stellen eine grundlegende Abweichung von der frequentistischen Perspektive dar und beziehen Vorwissen oder Überzeugungen in die Analyse ein. Anhand der Daten liefert dieser Ansatz Intervalle, die als Wahrscheinlichkeit des darin liegenden Parameters interpretiert werden können, was im Gegensatz zur frequentistischen Interpretation steht, die den Parametern keine Wahrscheinlichkeiten zuordnet. Trotz ihrer intuitiven Anziehungskraft unterliegen Bayes'sche Methoden einer Prüfung hinsichtlich der Wahl des Priors, was die Ergebnisse erheblich beeinflussen kann, insbesondere in Fällen mit begrenzten Daten.
Frequentistische vs. bayesianische Interpretationen
Die Debatte zwischen frequentistischen und bayesianischen Methoden konzentriert sich auf grundlegende philosophische Unterschiede bei der Interpretation von Wahrscheinlichkeiten. Frequentisten betrachten Wahrscheinlichkeit als die langfristige Häufigkeit von Ereignissen, was zu Konfidenzintervallen führt, die die Eigenschaften des Verfahrens über viele Wiederholungen hinweg widerspiegeln. Umgekehrt interpretieren Bayesianer die Wahrscheinlichkeit als einen Grad der Überzeugung, was direktere probabilistische Aussagen über Parameter ermöglicht. Diese Debatte unterstreicht die unterschiedlichen Ansätze zur statistischen Schlussfolgerung und die Auswirkungen auf die Entscheidungsfindung und wissenschaftliche Schlussfolgerungen.
Einschränkungen und Kritikpunkte traditioneller Interpretationen von Vertrauensgrenzen
Traditionelle Interpretationen von Konfidenzgrenzen, die im frequentistischen Paradigma verwurzelt sind, werden wegen ihres manchmal kontraintuitiven Charakters und der Möglichkeit einer Fehlinterpretation kritisiert. Beispielsweise gibt das feste Konfidenzniveau (z. B. 95 %) nicht direkt die Wahrscheinlichkeit an, dass der Parameter innerhalb des Intervalls für eine bestimmte Studie liegt. Darüber hinaus kann die Abhängigkeit von Näherungen für große Stichproben bei manchen Methoden für Studien mit kleinen Stichproben problematisch sein und zu irreführenden Schlussfolgerungen führen.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Fazit
Dieser Artikel beleuchtet die vielschichtige Welt der Grenzen des Selbstvertrauensund erläutert deren Grundlagen, Berechnungsmethoden, Interpretationsnuancen und interdisziplinäre Anwendungen. Durch die Analyse der theoretischen Grundlagen wird deutlich, wie diese Grenzen als zentrale Werkzeuge der statistischen Analyse dienen und eine probabilistische Perspektive bieten, mit der die Zuverlässigkeit und Präzision datenbasierter Erkenntnisse bewertet werden können. Die Untersuchung von Berechnungstechniken, unterstützt durch moderne Software-Tools wie R und Python, unterstreicht die Entwicklung statistischer Verfahren hin zu mehr Effizienz und Zugänglichkeit. Die Auseinandersetzung mit Interpretationsschwierigkeiten und die Aufklärung gängiger Missverständnisse verdeutlichen die Bedeutung eines differenzierten Verständnisses für eine fundierte wissenschaftliche Forschung. Der Diskurs erstreckt sich auf verschiedene Bereiche und zeigt, dass Grenzen des Selbstvertrauens unverzichtbar für die Gestaltung von Forschung, Politikgestaltung und praktischer Entscheidungsfindung in unterschiedlichsten Bereichen sind.
Empfohlene Artikel
Erfahren Sie mehr über statistische Methoden und verbessern Sie Ihre Datenanalysefähigkeiten, indem Sie sich in andere aufschlussreiche Artikel in unserem Blog vertiefen.
- Konfidenzintervallrechner: Ihr Werkzeug für zuverlässige statistische Analysen
- Konfidenzintervalle interpretieren: Ein umfassender Leitfaden
- Vertrauensgrenzen und die Grenzen des Vertrauens (Externer Link)
- Statistiken vs. Parameter: Ein umfassender FAQ-Leitfaden
- Wie sind Konfidenzintervalle zu interpretieren?
- Erforschung der Standardabweichung (Geschichte)
Häufig gestellte Fragen (FAQs)
Frage 1: Was versteht man unter 95%-Konfidenzintervallen?95%-Konfidenzintervalle definieren einen Bereich, der aus Stichprobendaten berechnet wird. Würde die Studie mehrmals wiederholt, würden voraussichtlich 95 % dieser Konfidenzintervalle den wahren Populationsparameter (z. B. einen Mittelwert oder Anteil) enthalten. Dies unterstreicht die Zuverlässigkeit der Methode über viele Wiederholungen hinweg und nicht die Gewissheit, dass ein einzelnes Intervall den Parameter enthält.
Frage 2: Wie interpretiert man Konfidenzintervalle?Konfidenzintervalle geben den Bereich an, in dem der wahre Populationsparameter erwartet wird. Sie spiegeln die Unsicherheit der Schätzung wider; größere Intervalle deuten auf eine höhere Unsicherheit hin.
Frage 3: Was ist ein 90%-Konfidenzintervall?Ein 90%-Konfidenzintervall definiert einen Bereich, der bei mehrfacher Wiederholung der Studie unter gleichen Bedingungen den wahren Populationsparameter in 90 % dieser Studien umfassen soll. Es stellt ein Gleichgewicht zwischen Präzision und Sicherheit dar, wobei das Intervall im Vergleich zu einem 95%-Konfidenzintervall enger ist und das Risiko höher, dass der Parameter in einer Studie nicht im Intervall enthalten ist.
Frage 4: Was ist die 95%-Konfidenzgrenze der Abweichungen?Die 95%-Konfidenzgrenze der Abweichungen gibt den Bereich an, in dem 95 % der Abweichungen vom Mittelwert (in einem Datensatz) zu erwarten sind und spiegelt die Variabilität der Daten wider.
Frage 5: Wie erleichtern Software-Tools wie R und Python die Berechnung von Konfidenzintervallen?Software-Tools wie R und Python bieten integrierte Funktionen und Bibliotheken, wie z. B. 't.test' in R und 'scipy.stats' in Python, um komplexe Berechnungen zur Bestimmung von Konfidenzintervallen zu automatisieren und so Effizienz und Genauigkeit zu verbessern.
Frage 6: Wie beeinflussen Stichprobenumfang und Varianz die Breite der Konfidenzintervalle?Größere Stichprobenumfänge und eine geringere Varianz führen zu engeren Konfidenzintervallen, was auf präzisere Schätzungen der Populationsparameter hindeutet. Kleinere Stichproben oder eine höhere Varianz erweitern die Konfidenzintervalle und spiegeln eine größere Unsicherheit wider.
Frage 7: Welche Rolle spielen nichtparametrische Methoden bei der Berechnung von Konfidenzintervallen?Nichtparametrische Methoden wie Bootstrapping schätzen Konfidenzintervalle, ohne auf Annahmen über eine Normalverteilung angewiesen zu sein. Dadurch sind sie nützlich für Daten, die nicht den traditionellen parametrischen Kriterien entsprechen, allerdings oft mit einem erhöhten Rechenaufwand.
Frage 8: Worin unterscheiden sich Bayes'sche Konfidenzintervalle von traditionellen frequentistischen Konfidenzintervallen?Bayes'sche Konfidenzintervalle, auch Glaubwürdigkeitsintervalle genannt, beziehen Vorwissen mit ein und sind als Wahrscheinlichkeit interpretierbar, dass der Parameter innerhalb des Intervalls liegt, im Gegensatz zu frequentistischen Intervallen, die den Parametern keine Wahrscheinlichkeiten zuweisen.
Frage 9: Welche Auswirkungen hat eine Fehlinterpretation von Konfidenzintervallen in der Forschung?Eine Fehlinterpretation von Konfidenzintervallen kann zu falschen Schlussfolgerungen führen, beispielsweise zu einer Überschätzung der Sicherheit von Ergebnissen, wodurch die Gültigkeit der Forschung und nachfolgender, auf der Analyse basierender Entscheidungen beeinträchtigt werden kann.
Frage 10: In welcher Weise werden Konfidenzintervalle in verschiedenen Disziplinen angewendet?Konfidenzintervalle werden in verschiedenen Bereichen eingesetzt, von der Bewertung neuer medizinischer Behandlungen und Umweltpolitiken bis hin zu Wirtschaftsprognosen, wo sie Unsicherheiten quantifizieren und als Grundlage für Entscheidungsfindung, Politikformulierung und Naturschutzstrategien dienen.