Hauptkomponentenanalyse: Daten in wahrheitsgetreue Erkenntnisse umwandeln
Sie lernen die Leistungsfähigkeit der Hauptkomponentenanalyse bei der Aufdeckung verborgener Datenwahrheiten kennen.
Einführung
Hauptkomponentenanalyse (PCA)ist eine zentrale Technik in Statistik und Data Science. Sie bietet eine ausgefeilte Methode zur Dimensionsreduktion großer Datensätze, wobei die Variabilität der Daten weitestgehend erhalten bleibt. Dieses Verfahren vereinfacht die Komplexität mehrdimensionaler Daten und verbessert deren Interpretierbarkeit, ohne die Integrität der Originaldaten wesentlich zu beeinträchtigen. Im Kern zielt die PCA darauf ab, Muster in Daten zu identifizieren, Diskrepanzen aufzuzeigen und komplexe Datensätze in eine übersichtlichere Form zu bringen. Dadurch können Analysten und Wissenschaftler effizienter aussagekräftige Erkenntnisse gewinnen. Dieser Artikel möchtePCAverständlich machen und die Leser durch ihre konzeptionellen Grundlagen, praktischen Anwendungen und ihren tiefgreifenden Einfluss auf Datenanalyse führen . Mit dem Fokus aufPCAmöchten wir sowohl Interessierten als auch Fachleuten den Weg weisen und ein tieferes Verständnis und die Beherrschung dieses unverzichtbaren Analysewerkzeugs fördern.
Highlights
- PCA reduziert die Datengröße und behält gleichzeitig die wesentlichen Datenmerkmale bei.
- Historisch gesehen hat sich PCA von einfachen Konzepten zu komplexen Anwendungen in der Genomik und im Finanzwesen entwickelt.
- Die korrekte Verwendung von PCA kann Muster in Daten aufdecken, die zunächst nicht erkennbar waren.
- Die Auswahl der richtigen Anzahl von Komponenten in PCA ist entscheidend für eine genaue Dateninterpretation.
- PCA-Tools und -Software rationalisieren die Analyse und machen Dateneinblicke leichter zugänglich.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Die Essenz der Hauptkomponentenanalyse
Hauptkomponentenanalyse (PCA)ist ein statistisches Verfahren, das mithilfe einer orthogonalen Transformation einen Satz von Beobachtungen möglicherweise korrelierter Variablen in Werte linear unkorrelierter Variablen, sogenannte Hauptkomponenten, umwandelt. Diese Technik ist weithin anerkannt für ihre Fähigkeit, die Dimensionalität von Daten zu reduzieren und gleichzeitig den Großteil der Varianz im Datensatz zu erhalten. Der Kern der PCA liegt in ihrer Fähigkeit, die wesentlichen Informationen aus der Datentabelle zu extrahieren, die Größe des Datensatzes zu komprimieren und die Beschreibung des Datensatzes zu vereinfachen, während die wertvollsten Aspekte aller Variablen erhalten bleiben.
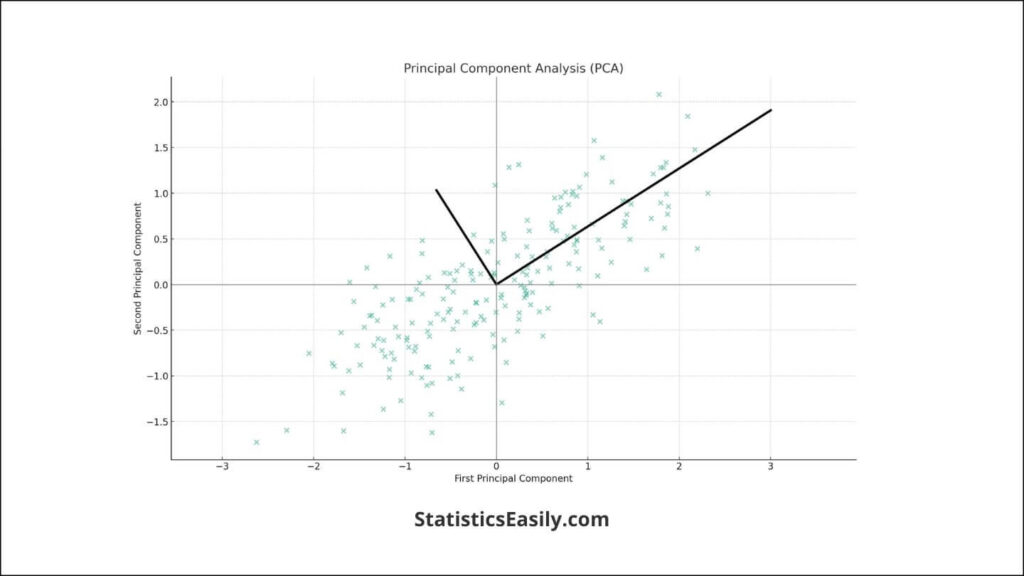
Zu den Kernprinzipien der PCA gehört die Identifizierung von Richtungen oder Achsen, entlang derer die Variabilität der Daten maximiert wird. Die erste Hauptkomponente ist die Richtung, die die Varianz der Daten maximiert. Die zweite Hauptkomponente ist orthogonal zur ersten. Es identifiziert die Richtung der folgenden höchsten Varianz und so weiter. Dieser Prozess ermöglicht es PCA, komplexe Datensätze auf eine niedrigere Dimension zu reduzieren, was die Analyse und Visualisierung der Daten ohne nennenswerten Informationsverlust erleichtert.
Die Vorteile von PCA bei der Vereinfachung komplexer Datensätze bei gleichzeitiger Beibehaltung wesentlicher Informationen sind beispiellos. Es ermöglicht Datenwissenschaftlern und Statistikern, verborgene Muster in den Daten aufzudecken und so eine fundiertere Entscheidungsfindung zu ermöglichen. Durch die Konzentration auf die wichtigsten Komponenten trägt PCA dazu bei, die zugrunde liegende Struktur der Daten hervorzuheben und so einen klareren Einblick in die wahre Natur der analysierten Daten zu ermöglichen. Diese Methode steigert die Effizienz der Datenanalyse. Es trägt zu einem wahrheitsgemäßeren und tieferen Verständnis der intrinsischen Eigenschaften der Daten bei.
Historischer Hintergrund und theoretische Grundlagen
Die Reise vonHauptkomponentenanalyse (PCA)reicht bis ins frühe 20. Jahrhundert zurück und basiert auf den Pionierarbeiten von Carl Pearson im Jahr 1901. Um die zugrundeliegende Datenstruktur zu verstehen, entwickelte Pearson die PCA, um die beobachtete Variabilität in einem mehrdimensionalen Datenraum mithilfe unkorrelierter Variablen zu beschreiben. Diese Technik wurde später in den 1930er Jahren von Harold Hotelling mathematisch formalisiert, wodurch eine robustere statistische Grundlage geschaffen und ihre Anwendbarkeit auf verschiedene wissenschaftliche Bereiche erweitert wurde.
Die mathematischen Grundlagen der PCA sind eng mit der linearen Algebra verknüpft, insbesondere mit den Konzepten der Eigenvektoren und Eigenwerte. Im Kern transformiert PCA die Originaldaten in ein neues Koordinatensystem, wobei die größten Abweichungen bei jeder Datenprojektion auf den ersten Koordinaten liegen, die als Hauptkomponenten bezeichnet werden. Diese Transformation wird durch die Eigenzerlegung der Datenkovarianzmatrix oder die Singularwertzerlegung (SVD) der Datenmatrix erreicht. Diese Methoden gewährleisten die Maximierung der Varianz und bewahren die strukturelle Integrität des Datensatzes.
Die Präzision und Wahrhaftigkeit von PCA liegt in seiner mathematischen Genauigkeit. PCA kapselt die inhärente Variabilität der Daten und die Beziehungen zwischen Variablen mithilfe der Kovarianzmatrix und bietet eine destillierte Ansicht, die die wichtigsten Muster hervorhebt. Dieser Prozess vereinfacht nicht nur die Komplexität der Daten, sondern rückt auch die wesentliche Wahrheit – die zugrunde liegende Struktur und Variabilität der Daten – in den Vordergrund und ermöglicht so eine aufschlussreiche Analyse und Entscheidungsfindung.
PCA hat sich durch seine Entwicklung und seine mathematischen Grundlagen als Eckpfeiler der statistischen Datenanalyse etabliert. Seine Fähigkeit, die Dimensionalität zu reduzieren und gleichzeitig wesentliche Informationen zu bewahren, hat es zu einem unschätzbar wertvollen Werkzeug für Datenwissenschaftler und Statistiker gemacht, das ein tieferes Verständnis von Daten in zahlreichen Bereichen ermöglicht.
Praktische Anwendungen der Hauptkomponentenanalyse
Hauptkomponentenanalyse (PCA)hat ihre akademischen Ursprünge hinter sich gelassen und sich zu einem unverzichtbaren Analysewerkzeug in zahlreichen Anwendungsbereichen entwickelt. Ihre Fähigkeit, große Datensätze in überschaubare Erkenntnisse zu übersetzen, hat die Interpretation komplexer Informationen revolutioniert und sie in so unterschiedlichen Bereichen wie Genomik, Finanzen und digitaler Bildverarbeitung unentbehrlich gemacht.
In der Genomikvereinfacht die Hauptkomponentenanalyse (PCA) genetische Daten, die oft Tausende von Variablen umfassen. Durch die Reduzierung der Dimensionalität ermöglicht die PCA Forschern, genetische Marker und krankheitsbezogene Muster effizienter zu identifizieren und so Durchbrüche in der personalisierten Medizin und der Evolutionsforschung zu erzielen.
The Finanzsektornutzt die Hauptkomponentenanalyse (PCA) für Risikomanagement und Anlagestrategien. Durch die Analyse der Kovarianzmatrix von Vermögensrenditen kann die PCA die Hauptfaktoren aufzeigen, die Marktschwankungen beeinflussen. Diese Vereinfachung trägt zur Portfoliodiversifizierung bei und verdeutlicht zugrunde liegende Trends, die mit traditionellen Analysemethoden möglicherweise nicht erkennbar sind.
In der Bildkomprimierungreduziert die Hauptkomponentenanalyse (PCA) die Redundanz in den Pixeldaten und ermöglicht so die effiziente Speicherung und Übertragung von Bildern ohne signifikanten Qualitätsverlust. Diese Anwendung ist in Bereichen mit begrenzter Bandbreite, wie Satellitenbildern und Telemedizin, von entscheidender Bedeutung, wobei ein ausgewogenes Verhältnis zwischen Komprimierung und Erhalt der Bildintegrität unerlässlich ist.
PCA deckt durch diese Anwendungen zugrunde liegende Muster in Daten auf und vereinfacht Entscheidungsprozesse erheblich. Durch die Zerlegung komplexer Datensätze in ihre wichtigsten Komponenten spiegelt PCA die inhärente Güte der Datenanalyse wider und wandelt überwältigende Datenmengen in umsetzbare Erkenntnisse um. Dieser Übergang von Komplexität zu Klarheit verbessert unser Verständnis der Daten. Es ermöglicht uns, fundierte Entscheidungen in einem Spektrum kritischer Bereiche zu treffen und stellt die Vielseitigkeit und dauerhafte Relevanz von PCA unter Beweis.
Schritt-für-Schritt-Anleitung zur Durchführung der Hauptkomponentenanalyse in Python
Durch die Durchführung der Hauptkomponentenanalyse (PCA) in Python werden große Datensätze effizient in ihre wichtigsten Komponenten komprimiert und so die Datenanalyse vereinfacht. Dieser Leitfaden führt Sie durch den Prozess von der Datenaufbereitung bis zur Interpretation und nutzt dabei die scikit-learn-Bibliothek, die für ihre leistungsstarken Data-Mining- und Analysetools bekannt ist.
1. Datenaufbereitung
Stellen Sie vor der Implementierung von PCA sicher, dass Ihre Daten für den Prozess geeignet sind. Dies bedeutet, mit fehlenden Werten umzugehen, die Daten zu normalisieren und Features zu reduzieren, wenn sie stark korreliert sind.
import pandas as pd
from sklearn.preprocessing import StandardScaler

# Load dataset
df = pd.read_csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df.fillna(method='ffill', inplace=True)

## Feature scaling
features = ['Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6']
x = df.loc[:, features].values
x = StandardScaler().fit_transform(x)  # Normalize data
2. PCA implementieren
Wenn die Daten vorbereitet sind, können Sie PCA anwenden. Entscheiden Sie, wie viele Hauptkomponenten Sie beibehalten möchten, oder lassen Sie den Algorithmus anhand der Varianz auswählen.
from sklearn.decomposition import PCA

# PCA transformation
pca = PCA(n_components=2)  # n_components to specify desired reduction
principalComponents = pca.fit_transform(x)

# Convert to a DataFrame
principalDf = pd.DataFrame(data=principalComponents, columns=['Principal Component 1', 'Principal Component 2'])
3. Analyse der Ergebnisse
Analysieren Sie nach der Transformation der Daten die Hauptkomponenten, um die zugrunde liegende Struktur des Datensatzes zu verstehen.
print(pca.explained_variance_ratio_)
Dadurch wird die durch jede der ausgewählten Hauptkomponenten erläuterte Varianz gedruckt, die Aufschluss darüber gibt, wie viele Informationen durch die Analyse erfasst werden.
4. Visualisierung
Die Visualisierung der Hauptkomponenten kann intuitive Einblicke in die Datenstruktur und das Clustering ermöglichen.
import matplotlib.pyplot as plt

plt.figure(figsize=(8,6))
plt.scatter(principalDf['Principal Component 1'], principalDf['Principal Component 2'])
plt.xlabel('Principal Component 1')
plt.ylabel('Principal Component 2')
plt.title('PCA on Dataset')
plt.show()
5. Deutung
Bei der Interpretation geht es darum, die Hauptkomponenten im Hinblick auf die ursprünglichen Merkmale zu verstehen. Dies erfordert häufig Domänenkenntnisse und einen Blick auf die Gewichte der PCA-Komponenten.
# Accessing the components_
print(abs(pca.components_))
Dies zeigt das Gewicht jedes Originalmerkmals in den Hauptkomponenten und hilft bei der Interpretation der Komponenten.
Beispieldatensatzergebnisse
Anhand eines hypothetischen Datensatzes könnte die PCA ergeben, dass die ersten beiden Hauptkomponenten einen erheblichen Teil der Varianz in den Daten erfassen. Die Visualisierung zeigt möglicherweise eine klare Clusterbildung, was auf unterschiedliche Gruppen innerhalb des Datensatzes schließen lässt. Die Komponentengewichte könnten Aufschluss darüber geben, welche Merkmale diese Gruppierungen am meisten beeinflussen.
Schritt-für-Schritt-Anleitung zur Durchführung der Hauptkomponentenanalyse für R
Die Hauptkomponentenanalyse (PCA) in R reduziert große Datensätze effizient auf ihre wichtigsten Komponenten und vereinfacht so die Datenanalyse. Dieser Leitfaden führt Sie von der Datenaufbereitung bis zur Interpretation durch den gesamten Prozess und nutzt dabei die vielseitigen und umfassenden Werkzeuge von R für statistische Berechnungen.
1. Datenaufbereitung
Stellen Sie vor der Implementierung von PCA sicher, dass Ihre Daten für den Prozess geeignet sind. Dazu gehört der Umgang mit fehlenden Werten, die Standardisierung der Daten und die Reduzierung von Merkmalen, wenn diese stark korrelieren.
# Load dataset
df <- read.csv('data_pca.csv')

# Preprocessing
## Handle missing values if any
df[is.na(df)] <- method = na.omit(df)

## Feature scaling
features <- df[, c('Feature1', 'Feature2', 'Feature3', 'Feature4', 'Feature5', 'Feature6')]
scaled_features <- scale(features) # Normalize data
2. PCA implementieren
Mit den vorbereiteten Daten kann PCA angewendet werden. Sie können entscheiden, wie viele Hauptkomponenten Sie beibehalten möchten, oder den Algorithmus auf der Grundlage der erklärten Varianz auswählen lassen.
# PCA transformation
pca <- prcomp(scaled_features, rank. = 2, center = TRUE, scale. = TRUE)

# The rank. argument specifies the desired reduction
# prcomp automatically centers and scales the variables
3. Analyse der Ergebnisse
Nach der Transformation der Daten kann die Zusammenfassung des PCA-Objekts verwendet werden, um die durch die Hauptkomponenten erläuterte Varianz zu verstehen.
# This prints the summary of the PCA object
summary(pca)
4. Visualisierung
Die Visualisierung der Hauptkomponenten kann intuitive Einblicke in die Datenstruktur und mögliche Clusterbildung bieten.
# This creates a scatter plot of the first two principal components
plot(pca$x[, 1:2], col = df$YourGroupVariable, xlab = 'Principal Component 1', ylab = 'Principal Component 2', main = 'PCA on Dataset')
5. Deutung
Bei der Interpretation von PCA geht es darum, zu verstehen, wie die ursprünglichen Merkmale zu den Hauptkomponenten beitragen, was häufig Domänenkenntnisse erfordert.
# This shows the loading of each original feature on the principal components
pca$rotation
Beispieldatensatzergebnisse
Unter Verwendung eines hypothetischen Datensatzes könnte PCA in R zeigen, dass die ersten beiden Hauptkomponenten einen erheblichen Teil der Varianz in den Daten erfassen. Die Visualisierung kann eine offensichtliche Clusterbildung zeigen, was auf unterschiedliche Gruppen innerhalb des Datensatzes schließen lässt. Die Untersuchung der Rotation (Beladungen) kann Aufschluss darüber geben, welche Merkmale diese Gruppierungen am meisten beeinflussen.
Best Practices und häufige Fallstricke
Für die Interpretation aussagekräftiger Daten mittels Hauptkomponentenanalyse (PCA) ist es von entscheidender Bedeutung, sich an Best Practices zu halten und auf häufige Fallstricke zu achten. Genauigkeit und die wahrheitsgetreue Darstellung des Wesens des Datensatzes sind von entscheidender Bedeutung.
Genauigkeit sicherstellen
- Datenstandardisierung: Standardisieren Sie Ihre Daten immer, bevor Sie PCA anwenden, da die Analyse empfindlich auf die Varianzen der Anfangsvariablen reagiert.
- Fehlende Werte: Beheben Sie alle fehlenden oder unendlichen Werte im Datensatz, um Verzerrungen bei der Komponentenextraktion zu verhindern.
- Ausreißer: Untersuchen und verstehen Sie Ausreißer vor der PCA, da diese die Ergebnisse unverhältnismäßig beeinflussen können.
Fehlinterpretationen vermeiden
- Interpretierbarkeit der Komponenten: Die Hauptkomponenten sind mathematische Konstrukte, die möglicherweise nicht immer eine direkte Interpretation in der realen Welt haben. Achten Sie darauf, sie nicht zu überinterpretieren.
- Abweichungen: Ein hohes Varianzverhältnis für die ersten paar Komponenten garantiert nicht, dass sie alle aussagekräftigen Informationen enthalten. Bei Komponenten mit geringerer Varianz können wichtige Feinheiten vorhanden sein.
Auswahl der richtigen Anzahl an Komponenten
- Erklärte Varianz: Verwenden Sie ein Scree-Plot oder ein kumulatives erklärtes Varianzverhältnis, um einen Ellbogenpunkt oder die Anzahl der Komponenten zu identifizieren, die wesentliche Informationen erfassen.
- Sparsamkeit: Bringen Sie Komplexität mit Interpretierbarkeit in Einklang und wählen Sie die kleinste Anzahl von Komponenten aus, die dennoch einen umfassenden Überblick über die Datenstruktur bieten.
- Fachwissen: Nutzen Sie das Wissen aus Ihrem Fachgebiet, um zu entscheiden, wie viele Komponenten Sie beibehalten möchten, und stellen Sie sicher, dass sie für Ihren spezifischen Kontext sinnvoll sind.
Der Essenz der Daten treu bleiben
- Übereinstimmung mit den Zielen: Passen Sie die Anzahl der beibehaltenen Komponenten an die Analyseziele an, sei es Datenvereinfachung, Rauschreduzierung oder Aufdeckung latenter Strukturen.
- Umfassende Überprüfung: Kombinieren Sie PCA mit anderen Datenexplorationstechniken, um ein ganzheitliches Verständnis der Daten aufzubauen.
Wenn Sie diese Richtlinien befolgen, wird Ihre PCA zu einer zuverlässigen Analyse führen, die Integrität der Daten wahren und gleichzeitig umsetzbare Erkenntnisse gewinnen. Indem man die mit der PCA einhergehenden Feinheiten im Auge behält, kann man die Fallstricke vermeiden, die zu Fehlinterpretationen führen, und sicherstellen, dass die Analyse ein authentisches Abbild des zugrunde liegenden Datensatzes bleibt.
Fortgeschrittene Themen der Hauptkomponentenanalyse
Während die Datenlandschaft weiter wächst und sich diversifiziert, entwickelt sich die Hauptkomponentenanalyse (PCA) weiter und vereint ihre klassischen Wurzeln mit innovativen Erweiterungen, um der Komplexität moderner Datenstrukturen gerecht zu werden. Diese Reise in die fortgeschrittenen Themen von PCA zeigt die Vielseitigkeit und dauerhafte Anpassungsfähigkeit der Methode in der Datenwissenschaft.
Variationen von PCA
- Kernel-PCA: Diese Erweiterung von PCA wird zur nichtlinearen Dimensionsreduktion verwendet. Durch die Verwendung von Kernel-Methoden wird die Struktur von Daten effektiv erfasst, wenn die Beziehung zwischen Variablen nicht linear ist, wodurch Muster aufgedeckt werden, die herkömmliche PCA möglicherweise übersehen.
- Sparsame PCA: In Datensätzen, in denen es mehr Features als Beobachtungen gibt, glänzt Sparse PCA, indem es Hauptkomponenten mit spärlichen Ladungen erzeugt. Dies führt zu einem besser interpretierbaren Modell, das eine kleinere Teilmenge von Merkmalen hervorhebt, was besonders in hochdimensionalen Datenszenarien wie der Genomik nützlich ist.
Erweiterungen von PCA
- Inkrementelle PCA: Für riesige Datensätze, die nicht in den Speicher passen, bietet Inkrementelle PCA eine Lösung. Es zerlegt die PCA-Berechnung in überschaubare Mini-Batches und aktualisiert die Komponenten schrittweise, was auch für das Streaming von Daten von Vorteil ist.
- Robustes PCA: Ausreißer können das Ergebnis der PCA erheblich beeinflussen. Robustes PCA mildert dies, indem es die spärlichen Ausreißer von der Struktur mit niedrigem Rang trennt und so sicherstellt, dass anomale Punkte die Kerndaten nicht verzerren.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Fazit
Die Hauptkomponentenanalyse (PCA) hat sich als unverzichtbare Technik im Werkzeugkasten der Datenanalyse fest etabliert. Es erleichtert ein tieferes Verständnis von Daten, indem es ihre informativsten Elemente extrahiert. Ziel dieses Leitfadens ist es, die PCA-Methodik zu verdeutlichen, von der grundlegenden Mathematik bis hin zu ihrer Anwendung in verschiedenen Bereichen. Wir haben seinen Nutzen bei der Reduzierung der Dimensionalität unter Beibehaltung der inhärenten Datenstruktur hervorgehoben. Dieser Prozess hilft sowohl bei der Visualisierung als auch bei der anschließenden Analyse erheblich. Forscher und Datenwissenschaftler werden ermutigt, PCA in ihre Arbeitsabläufe zu integrieren, um die Interpretierbarkeit komplexer Datensätze zu verbessern. Bei sorgfältiger Implementierung liefert PCA Einblicke in die vorherrschenden Muster in Daten und optimiert den Weg zu einer fundierteren und fundierteren Entscheidungsfindung.
Empfohlene Artikel
Entdecken Sie die umfangreiche Artikelbibliothek unseres Blogs zu verwandten Themen, um mehr über die Datenanalyse zu erfahren.
- Richard-Feynman-Technik: Ein Weg, um alles in der Datenanalyse zu lernen
- Verteilungen verallgemeinerter linearer Modelle verstehen
- Können Standardabweichungen negativ sein? (Geschichte)
- Boxplot: Ein leistungsstarkes Datenvisualisierungstool
- Verallgemeinerte lineare Modelle (Geschichte)
Häufig gestellte Fragen (FAQs)
PCA ist ein quantitatives Verfahren, das darauf abzielt, Variationen hervorzuheben und signifikante Muster aus einem Datensatz zu extrahieren und so die Hauptachsen der Variabilität effektiv zu identifizieren.
PCA spielt eine entscheidende Rolle bei der Vereinfachung hochdimensionaler Datensätze, indem es Kerntrends und -muster beibehält und so die Interpretierbarkeit ohne nennenswerten Informationsverlust verbessert.
PCA berechnet die Hauptkomponenten, die die Varianz innerhalb des Datensatzes maximieren, und transformiert die Daten in ein neues Koordinatensystem mit diesen Hauptachsen.
Tatsächlich ist PCA ein wertvolles Werkzeug für Vorhersagemodelle, da es die Dimensionalität reduziert und so die Modellleistung verbessert, indem Rauschen und weniger relevante Informationen herausgefiltert werden.
PCA wird häufig in verschiedenen analytischen Bereichen eingesetzt, darunter Finanzen, Biostatistik und Sozialwissenschaften, wo es bei der Analyse und dem Verständnis komplexer Daten hilft.
Die Auswahl der Komponenten in der PCA sollte sich an der erklärten Varianz orientieren, typischerweise anhand von Scree-Plots oder kumulativer Varianz bewertet und gegen die Interpretierbarkeit der Daten abgewogen werden.
PCA ist möglicherweise weniger effektiv bei Datensätzen, bei denen die Beziehungen zwischen Variablen nichtlinear sind und empfindlich auf die Datenskalierung reagieren.
PCA ist optimal für kontinuierliche numerische Daten. Für kategoriale Daten sind spezifische Vorverarbeitungsschritte erforderlich, um die genaue Anwendung von PCA-Techniken sicherzustellen.
PCA unterstützt die Datenanonymisierung, indem es Originalvariablen in Hauptkomponenten umwandelt, was die direkte Identifizierung einzelner Datensätze erschwert.
Bibliotheken für PCA sind in Softwareumgebungen wie R und Python leicht verfügbar, insbesondere in Paketen wie scikit-learn, die umfassende Tools für die PCA-Ausführung bereitstellen.