Lineare Regression mit Scikit-Learn: Ein umfassender Leitfaden
Mit scikit-learn erlernen Sie die Kunst und Wissenschaft der prädiktiven Modellierung mit linearer Regression.
Einführung
Die lineare Regression ist eine grundlegende Technik der Datenwissenschaft, die die Vorhersage und Interpretation von Beziehungen zwischen Variablen ermöglicht. Im Kern modelliert die lineare Regression die Beziehung zwischen einer abhängigen Variablen und einer oder mehreren unabhängigen Variablen und verwendet dabei eine lineare Gleichung, um das Ergebnis vorherzusagen. Diese Einfachheit und ihre Interpretierbarkeit machen die lineare Regression zu einem wichtigen Werkzeug für Datenanalysten und Wissenschaftler verschiedener Disziplinen.
Dieser Artikel bietet eine umfassende Anleitung zur Implementierunglineare Regression mit scikit-learn, einer beliebten Python Bibliothek für maschinelles Lernen. Scikit-learn stellt eine breite Palette an Werkzeugen und Algorithmen für Datenanalyse und Modellierung bereit und ist daher sowohl für Einsteiger als auch für erfahrene Anwender bestens geeignet.
In diesem Leitfaden befassen wir uns mit den theoretischen Grundlagen und praktischen Anwendungen der linearen Regression. Beginnend mit den Grundlagen werden wir die Annahmen und die Mathematik untersuchen, die linearen Regressionsmodellen zugrunde liegen. Von dort aus werden wir zu praktischen, praktischen Beispielen übergehen und scikit-learn verwenden, um Daten vorzubereiten, lineare Regressionsmodelle zu erstellen und ihre Ergebnisse zu interpretieren. Um diese Konzepte zu veranschaulichen, können wir einen zuvor erstellten Datensatz verwenden, der den Prozess der linearen Regressionsanalyse von der Datenvorverarbeitung bis zur Modellbewertung demonstriert.
Durch die Kombination von theoretischem Wissen mit praktischen Fähigkeiten soll dieser Leitfaden den Lesern ein umfassendes Verständnis der linearen Regression im Kontext von Scikit-Learn vermitteln und sie darauf vorbereiten, diese Konzepte auf reale datenwissenschaftliche Herausforderungen anzuwenden.
Highlights
- Die lineare Regression mit scikit-learn kann Ergebnisse mit bemerkenswerter Genauigkeit vorhersagen.
- Die API von Scikit-learn vereinfacht komplexe statistische Analysen in verständliche Schritte.
- Die Datenvorverarbeitung in scikit-learn verbessert die Modellzuverlässigkeit und -integrität.
- Fortgeschrittene Techniken in scikit-learn bekämpfen Überanpassungen und verbessern die Modellgenauigkeit.
- Reale Anwendungen der linearen Regression mit Scikit-Learn führen zu wirkungsvollen Entscheidungen.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Lineare Regression verstehen
Die lineare Regression ist eine zentrale statistische Methode, die die zugrunde liegende Beziehung zwischen zwei oder mehr Variablen aufdeckt. Durch die Anpassung einer linearen Gleichung an beobachtete Daten können wir das Verhalten einer Variablen basierend auf dem Wissen einer anderen verstehen und vorhersagen. Bei dieser prädiktiven Modellierungstechnik geht es nicht nur darum, eine Linie zu finden, die am besten zu den Daten passt, sondern auch darum, die in den Daten verborgenen Wahrheiten aufzudecken und so eine fundierte Entscheidungsfindung zu ermöglichen.
Im Kern basiert die lineare Regression auf einer Reihe von Annahmen, die ihre praktische Anwendung sicherstellen:
Linearität: Die Beziehung zwischen den unabhängigen und abhängigen Variablen ist linear. Diese grundlegende Annahme bedeutet, dass eine Änderung einer unabhängigen Variablen eine proportionale Änderung der abhängigen Variablen zur Folge hat.
Unabhängigkeit: Die Beobachtungen sind voneinander unabhängig. Das Ergebnis jedes Datenpunkts hängt nicht von den Ergebnissen anderer Datenpunkte ab.
Homoskedastizität: Die Varianz der Fehlerterme (Residuen) ist über alle Stufen der unabhängigen Variablen hinweg konstant. Homoskedastizität gewährleistet, dass die Vorhersagegenauigkeit des Modells über den gesamten Wertebereich der unabhängigen Variablen einheitlich ist.
Normalverteilung der Fehler: Die Fehler der abhängigen Variablen sind für jeden festen Wert der unabhängigen Variablen normalverteilt. Diese Annahme erlaubt es uns, Schlussfolgerungen zu ziehen und Hypothesen über die Koeffizienten der unabhängigen Variablen zu testen.
Das Verständnis dieser Annahmen ist für die angemessene Anwendung der linearen Regression von entscheidender Bedeutung, da Verstöße gegen diese Annahmen zu ungenauen Modellen und irreführenden Ergebnissen führen können. Indem sichergestellt wird, dass die Daten diese Voraussetzungen erfüllen, können Praktiker die lineare Regression voll ausschöpfen und sie zu einem leistungsstarken Werkzeug zur Interpretation komplexer Datensätze machen.
Die Verwendung von scikit-learn für die lineare Regression umfasst die Vorbereitung der Daten, um diese Annahmen zu erfüllen, gefolgt von der Modellanpassung, -bewertung und -interpretation. Durch diesen Prozess wird die lineare Regression mit scikit-learn nicht nur zu einer mathematischen Formel, sondern zu einer Brücke zwischen Daten und Entscheidung, Theorie und Anwendung, die uns zu fundierteren und genaueren Vorhersagen führt.
Einführung in Scikit-Learn
Scikit-learn gilt als Leuchtturm in der Data-Science-Community und ist ein Beweis für den kollaborativen Geist und die Open-Source-Philosophie, die Innovationen in diesem Bereich vorantreiben. Als Bibliothek bietet scikit-learn eine umfassende Suite von Machine-Learning-Werkzeugen – von der Datenvorverarbeitung und Modellauswahl bis hin zu Evaluierung und Optimierung. Die Designprinzipien legen Wert auf Benutzerfreundlichkeit, Leistung und Vielseitigkeit und machen es so sowohl für Einsteiger zugänglich als auch robust genug für erfahrene Anwender.
Das Engagement der Bibliothek für hochwertige Dokumentation und das Engagement der Gemeinschaft ist ein weiteres Beispiel für die besten Praktiken in der Softwareentwicklung für wissenschaftliche und pädagogische Zwecke. Scikit-learn ist eine Sammlung von Algorithmen und eine Plattform zum Lernen, Experimentieren und Entdecken. Seine Architektur fördert Best Practices in der Datenmodellierung und stellt sicher, dass Benutzer auf modernste Techniken des maschinellen Lernens zugreifen und deren Prinzipien verstehen können.
Durch die Nutzung von scikit-learn für lineare Regression und darüber hinaus können Data Scientists zuverlässige und verständliche Vorhersagemodelle erstellen. Die Implementierung der linearen Regression in der Bibliothek, dargestellt durch die Klasse„LinearRegression“, bietet eine leistungsstarke und gleichzeitig intuitive Schnittstelle zum Anpassen von Modellen an Daten, zum Analysieren ihrer Leistung und zum Erstellen von Vorhersagen. Ob Sie einfache lineare Zusammenhänge untersuchen oder sich mit komplexen, mehrdimensionalen Datensätzen auseinandersetzen – scikit-learn dient als zuverlässiger Leitfaden durch die Feinheiten des maschinellen Lernens und vereint das gesammelte Wissen und die Expertise der globalen Data-Science-Community.
Vorbereiten Ihrer Daten
Bevor Sie mit scikit-learn in die Modellierungsphase eintauchen, müssen Sie Ihre Daten unbedingt sorgfältig vorbereiten, um die Integrität und Wahrhaftigkeit Ihrer Analyse sicherzustellen. Die Datenvorverarbeitung ist ein entscheidender Schritt in der Pipeline des maschinellen Lernens und umfasst die Bereinigung, Auswahl von Funktionen und die Aufteilung der Daten in Trainings- und Testsätze.
Merkmalsauswahl: Beginnen Sie damit, die Merkmale zu identifizieren, die den größten Einfluss auf Ihre abhängige Variable haben. Nicht alle Datenpunkte sind gleichwertig; manche haben möglicherweise nur geringen oder gar keinen Einfluss auf Ihre Ergebnisse und können, wenn sie einbezogen werden, zu Störungen führen.
Datenbereinigung: In diesem Schritt werden fehlende Werte, Ausreißer und möglicherweise fehlerhafte Daten behandelt, die die Ergebnisse Ihres Modells verfälschen können. Zu den Möglichkeiten, mit fehlenden Daten umzugehen, gehören die Imputation (Ersetzen fehlender Werte durch andere Datenpunkte), das Weglassen und das Entfernen von Datenpunkten oder Merkmalen mit fehlenden Werten.
Datenaufteilung: Die Aufteilung Ihrer Daten in Trainings- und Testdatensätze ist entscheidend. Dadurch können Sie Ihr Modell mit einem Teildatensatz trainieren und seine Leistung mit einem separaten, unbekannten Teildatensatz testen. Dies ermöglicht eine unvoreingenommene Bewertung Ihres Modells.
Betrachten wir unseren zuvor erstellten Datensatz als praktisches Beispiel:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

# Load the dataset
data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')

# Feature selection
X = data[['TV', 'Radio']]  # Independent variables
y = data['Sales']  # Dependent variable

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Model initialization and training
model = LinearRegression()
model.fit(X_train, y_train)

# Model evaluation
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f'Mean Squared Error: {mse}')
In diesem Beispiel haben wir unsere Daten aufbereitet, indem wir relevante Merkmale ( Werbebudgets fürFernsehenundRadio ) und die Zielvariable (Werbebudgets) und der Zielvariable (Umsatz) ausgewählt haben. Anschließend haben wir die Daten in Trainings- und Testdatensätze aufgeteilt, um eine faire Bewertung unseres Modells zu gewährleisten. Durch diese Schritte stellen wir sicher, dass unser Modell robust, präzise und realitätsnah ist.
Implementierung der linearen Regression mit Scikit-Learn
Die Implementierung der linearen Regression mit scikit-learn ist unkompliziert und veranschaulicht die Einfachheit und Leistungsfähigkeit der Bibliothek. Die Klarheit der API von scikit-learn macht selbst komplexe Analysen zugänglich und verständlich, sodass sich Datenwissenschaftler auf Erkenntnisse statt auf die Feinheiten der Algorithmen konzentrieren können.
Laden Sie den Datensatz herunter!
Schritt 1: Bibliotheken importieren und Daten laden – Beginnen Sie mit dem Import der benötigten Bibliotheken und dem Laden Ihres Datensatzes. Wir verwenden den zuvor vorbereiteten Datensatz:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score

data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')
Schritt 2: Merkmale und Zielgröße auswählen – Identifizieren Sie Ihre unabhängigen Variablen (Merkmale) und die abhängige Variable (Zielgröße). In unserem Fall sind „Fernsehen“ und „Radio“ die Merkmale und „Umsatz“ die Zielgröße.
X = data[['TV', 'Radio']]  # Features
y = data['Sales']  # Target
Schritt 3: Daten in Trainings- und Testdatensätze aufteilen – Um die Leistung des Modells effektiv zu bewerten, teilen Sie Ihre Daten in Trainings- und Testdatensätze auf:
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Schritt 4: Initialisierung und Training des linearen Regressionsmodells – Scikit-learn macht die Modellinitialisierung und das Training bemerkenswert einfach:
model = LinearRegression()
model.fit(X_train, y_train)
Schritt 5: Vorhersagen treffen und das Modell bewerten – Nachdem das Modell trainiert wurde, können Sie nun Vorhersagen für den Testdatensatz treffen und die Leistung des Modells bewerten:
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f"Mean Squared Error: {mse}")
print(f"R² Score: {r2}")
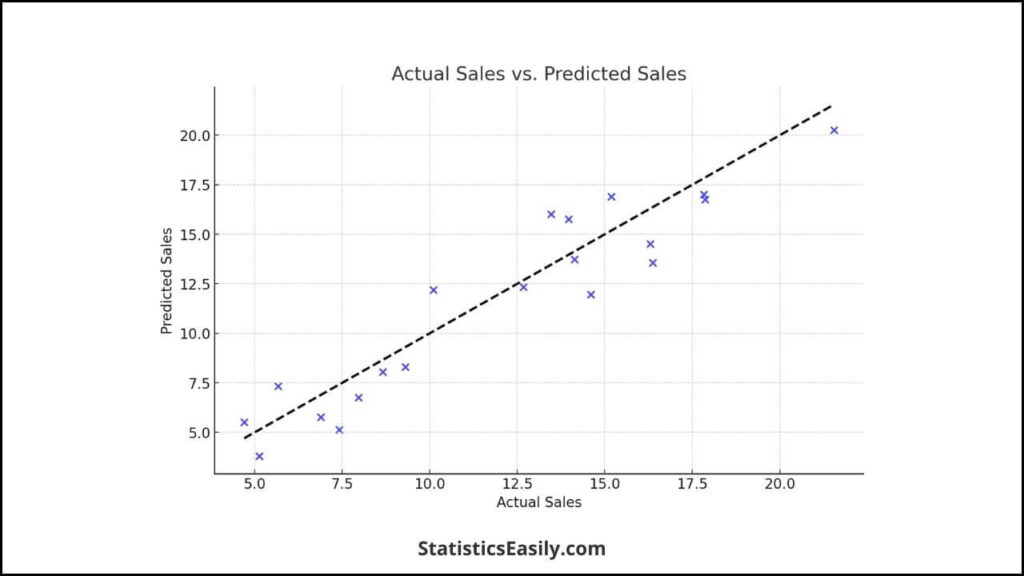
Visualisierung der Modellleistung – Visuelle Darstellungen können intuitive Einblicke in die Leistung des Modells liefern. Zum Beispiel durch die grafische Darstellung der tatsächlichen gegenüber den prognostizierten Umsätzen:
import matplotlib.pyplot as plt

plt.scatter(y_test, y_pred)
plt.xlabel('Actual Sales')
plt.ylabel('Predicted Sales')
plt.title('Actual Sales vs. Predicted Sales')
plt.show()
Dieses einfache Streudiagramm bietet eine schnelle visuelle Beurteilung der Vorhersagegenauigkeit des Modells, wobei Punkte näher an der Linie y = x auf eine bessere Leistung hinweisen.
Durch diese Schritte entmystifiziert scikit-learn den Prozess der Implementierung der linearen Regression und macht ihn sowohl Anfängern als auch erfahrenen Praktikern zugänglich. Wenn Sie diesem Leitfaden folgen, können Sie die Leistungsfähigkeit der linearen Regression nutzen, um aussagekräftige Erkenntnisse aus Ihren Daten zu gewinnen, ausgestattet mit der Klarheit und Einfachheit der API von scikit-learn.
Ergebnisse interpretieren
Die Interpretation der Ausgabe eines Regressionsmodells ist ein entscheidender Schritt im Analyseprozess und liefert Einblicke in die Beziehungen zwischen Variablen und die Vorhersagekraft des Modells. In diesem Abschnitt interpretieren wir das mit scikit-learn erstellte lineare Regressionsmodell und konzentrieren uns dabei auf die Bedeutung von Koeffizienten, Modellmetriken und ethischen Überlegungen bei der Präsentation der Ergebnisse.
Koeffizienteninterpretation
Die Koeffizienten in einem linearen Regressionsmodell stellen die Änderung der abhängigen Variablen für eine Änderung einer unabhängigen Variablen um eine Einheit dar, wobei alle anderen Variablen konstant bleiben. In unserem Modell geben die Koeffizienten für die Werbebudgets „TV“ und „Radio“ ihre jeweiligen Auswirkungen auf den „Umsatz“ an. Ein positiver Koeffizient deutet auf einen direkten Zusammenhang hin: Ein erhöhtes Werbebudget führt zu höheren Umsätzen. Im Gegensatz dazu weist ein negativer Koeffizient auf eine umgekehrte Beziehung hin.
Modellmetriken
Zwei Schlüsselmetriken zur Bewertung der Leistung eines linearen Regressionsmodells sind der mittlere quadratische Fehler (MSE) und der R-Quadrat-Wert (R²).
Der MSE-Wertmisst den Mittelwert der Fehlerquadrate, d. h. die durchschnittliche quadratische Abweichung zwischen den Schätzwerten und den tatsächlichen Werten. Ein niedrigerer MSE-Wert deutet auf ein Modell hin, das die Daten gut beschreibt.
R²repräsentiert den Anteil der Varianz der abhängigen Variable, der durch die unabhängigen Variablen vorhergesagt werden kann, und liegt zwischen 0 und 1. Ein R²-Wert nahe 1 deutet auf ein Modell hin, das einen großen Teil der Varianz der abhängigen Variable erklärt.
Ehrliche Interpretation und ethische Überlegungen
Bei der Interpretation und Darstellung der Ergebnisse einer Regressionsanalyse stehen Ehrlichkeit und ethische Überlegungen im Vordergrund. Es ist wichtig, die Grenzen des Modells anzuerkennen, einschließlich aller Annahmen, die möglicherweise nicht ganz zutreffen, oder Variablen, die nicht berücksichtigt werden konnten. Eine Überbewertung der Genauigkeit oder Vorhersagekraft des Modells kann zu Fehlentscheidungen und Fehlinterpretationen führen.
Transparenz über die Datenquellen, Vorverarbeitungsschritte und die Gründe für die Auswahl spezifischer Variablen fördern das Vertrauen und die Glaubwürdigkeit der Ergebnisse. Darüber hinaus ist jeder Datenwissenschaftler ethisch dafür verantwortlich, die potenziellen Auswirkungen dieser Ergebnisse auf die Interessengruppen zu berücksichtigen und sicherzustellen, dass die Interpretationen nicht irreführend oder schädlich sind.
Die Interpretation der Ergebnisse eines linearen Regressionsmodells erfordert eine sorgfältige Prüfung der Koeffizienten und Modellmetriken sowie die Verpflichtung zu Ehrlichkeit und ethischer Integrität bei der Präsentation der Ergebnisse. Dieser Ansatz stellt die Zuverlässigkeit der Analyse sicher und wahrt die Grundsätze der Wahrheit in der Datenwissenschaft.
Lineare Regression mit Scikit-Learn Advanced Topics
Im Bestreben, lineare Regressionsmodelle zu verfeinern und ihre Vorhersagegenauigkeit zu verbessern, entstehen mehrere fortschrittliche Techniken. Diese Methoden gehen auf häufige Herausforderungen wie Überanpassung ein, vertiefen unser Verständnis der linearen Regressionsanalyse und demonstrieren deren Vielseitigkeit und Tiefe.
Regularisierung: Ein Schlüssel zur Minderung von Überanpassung
Regularisierungstechniken wie Ridge (L2-Regularisierung) und Lasso (L1-Regularisierung) verhindern eine Überanpassung. Diese häufige Gefahr tritt auf, wenn das Modell bei Trainingsdaten gut, bei unsichtbaren Daten jedoch schlecht abschneidet. Durch die Einführung eines Strafterms in die Verlustfunktion schränken Regularisierungsmethoden die Größe der Koeffizienten ein und verhindern so, dass das Modell übermäßig komplex wird.
Bei der Ridge-Regressionwird eine Strafe in Höhe des Quadrats der Größe der Koeffizienten hinzugefügt, wodurch diese effektiv verkleinert und die Modellkomplexität reduziert wird.
Die Lasso-Regressionhingegen kann einige Koeffizienten auf Null reduzieren, eine Merkmalsauswahl durchführen und ein besser interpretierbares Modell liefern.
Die Implementierung in scikit-learn ist unkompliziert:
from sklearn.linear_model import Ridge, Lasso

# Ridge regression
ridge_model = Ridge(alpha=1.0)
ridge_model.fit(X_train, y_train)

# Lasso regression
lasso_model = Lasso(alpha=0.1)
lasso_model.fit(X_train, y_train)
The 'alpha'steuert die Stärke der Regularisierung; höhere Werte führen zu stärkeren Einschränkungen der Koeffizienten.
Modellbewertungs- und Validierungstechniken
Die Bewertung und Validierung der Leistung linearer Regressionsmodelle ist entscheidend für die Gewährleistung ihrer Zuverlässigkeit und Genauigkeit. Bei der Kreuzvalidierung, einer robusten Technik, wird der Datensatz in mehrere Teilmengen aufgeteilt und das Modell an einigen Teilmengen trainiert, während es an den übrigen getestet wird. Dieser Ansatz ermöglicht eine umfassendere Bewertung der Leistung des Modells über verschiedene Datensegmente hinweg.
from sklearn.model_selection import cross_val_score

# Cross-validation with 5 folds
scores = cross_val_score(model, X, y, cv=5, scoring='neg_mean_squared_error')
The `cross_val_score`in scikit-learn ermöglicht die Kreuzvalidierung, wobei der Parameter`cv`die Anzahl der Faltungen angibt. Die Wahl des Bewertungskriteriums, wie beispielsweise des negativen mittleren quadratischen Fehlers, hängt von den spezifischen Zielen der Analyse ab.
Streben nach Wahrheit und Genauigkeit in der Modellleistung
Die Einhaltung der Grundsätze der Wahrheit und Genauigkeit ist von größter Bedeutung, wenn die lineare Regressionsanalyse durch Techniken wie Regularisierung und Kreuzvalidierung vorangetrieben wird. Durch die Regularisierung wird die Wahrhaftigkeit des Modells beeinträchtigt, indem verhindert wird, dass es Rauschen anpasst. Gleichzeitig gewährleistet die Kreuzvalidierung die Genauigkeit der Leistungsmetriken des Modells durch eine ganzheitliche Bewertung.
Die ethische Darstellung der Datenergebnisse unter Anerkennung der Einschränkungen und potenziellen Verzerrungen des Modells stärkt die Integrität der Analyse. Diese fortschrittlichen Techniken und ethischen Überlegungen stellen sicher, dass die lineare Regressionsanalyse weiterhin ein leistungsstarkes Werkzeug im Arsenal des Datenwissenschaftlers ist, das in der Lage ist, Erkenntnisse mit Präzision und Zuverlässigkeit aufzudecken.
Lineare Regression mit Scikit-Learn in realen Anwendungen
Die Anwendung der linearen Regression im Bereich des Scikit-Learn geht weit über theoretische Konstrukte hinaus und verankert sich tief in der Struktur der Problemlösung in der realen Welt. Dieser Abschnitt beleuchtet den praktischen Nutzen der linearen Regression beim Scikit-Learn anhand anschaulicher Darstellungen ihrer Anwendung in verschiedenen Bereichen und unterstreicht die transformative Wirkung der Datenwissenschaft auf die Gesellschaft.
Prognose von Immobilienpreisen:Eine der wichtigsten Anwendungen der linearen Regression findet sich in der Immobilienbranche. Dort wird sie eingesetzt, um Immobilienpreise anhand verschiedener Merkmale wie Wohnfläche, Lage, Anzahl der Schlafzimmer und Alter der Immobilie vorherzusagen. Durch das Trainieren eines linearen Regressionsmodells mit historischen Daten können Immobilienanalysten den Marktwert von Immobilien schätzen und Käufer und Verkäufer bei fundierten Entscheidungen unterstützen.
Umsatz- und Ertragsprognosen:Unternehmen aller Branchen nutzen die lineare Regression, um Umsatz und Ertrag unter Berücksichtigung von Werbeausgaben, saisonalen Schwankungen und Konjunkturindikatoren zu prognostizieren. Beispielsweise kann ein Einzelhandelsunternehmen die lineare Regression einsetzen, um die Auswirkungen einer Werbekampagne auf den Umsatz zu analysieren und so Marketingbudgets strategisch für einen maximalen Return on Investment (ROI) zu verteilen.
Gesundheitswesen: Vorhersage des Krankheitsverlaufs:Im Gesundheitswesen spielen lineare Regressionsmodelle eine entscheidende Rolle bei der Vorhersage des Krankheitsverlaufs anhand von Patientendaten wie Alter, Gewicht, Blutdruck und Cholesterinspiegel. Diese Anwendung unterstützt nicht nur die Früherkennung und personalisierte Behandlungspläne, sondern auch die effiziente Zuteilung von Gesundheitsressourcen.
Energieverbrauchsanalyse:Analysten im Energiesektor nutzen lineare Regression, um Verbrauchsmuster auf Basis historischer Daten, Wetterbedingungen und Wirtschaftsentwicklung vorherzusagen. Solche Prognosen sind für Energieerzeugungs- und -verteilungsunternehmen entscheidend, um Angebot und Nachfrage effektiv zu steuern und so zu nachhaltigen Energiemanagementpraktiken beizutragen.
Erfolgsgeschichte: Steigerung der landwirtschaftlichen Erträge:Ein bemerkenswertes Beispiel für eine erfolgreiche Anwendung ist die lineare Regression in der Landwirtschaft zur Vorhersage von Ernteerträgen. Durch die Analyse von Variablen wie Niederschlag, Temperatur, Bodenqualität und Pflanzensorte können Agronomen Erträge prognostizieren und so die Anbaumethoden optimieren, um die Produktivität zu steigern. Dies stärkt die Ernährungssicherheit und fördert eine nachhaltige Landwirtschaft, indem Abfall und Ressourcenverbrauch minimiert werden.
Diese realen Anwendungen unterstreichen die Vielseitigkeit und Praktikabilität der linearen Regression mit scikit-learn bei der Bewältigung komplexer Herausforderungen in verschiedenen Bereichen. Durch die Nutzung der Macht von Daten zeigen lineare Regressionsmodelle Wege zu aufschlussreichen Entscheidungen auf, treiben den Fortschritt voran und fördern einen positiven Einfluss auf die Gesellschaft. Durch diese Erzählungen werden wir Zeuge der Verkörperung der Prinzipien von Wahrheit, Güte und Schönheit in der Anwendung der Datenwissenschaft und bekräftigen die tiefgreifende Rolle der linearen Regression bei der Gestaltung einer besseren Zukunft.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Fazit
Mit scikit-learn haben wir uns in die Welt derlineare Regression mit scikit-learneingelebt und dabei die theoretischen Grundlagen und praktischen Anwendungen einer der wichtigsten Techniken der Datenwissenschaft umfassend kennengelernt. Die lineare Regression ist ein Schlüssel zur Vorhersage und Interpretation des komplexen Zusammenspiels von abhängigen und unabhängigen Variablen – ihre Eleganz liegt in ihrer Einfachheit und Interpretierbarkeit.
Ziel dieses Leitfadens ist es, Ihnen als Leser ein fundiertes Verständnis der linearen Regression innerhalb des Scikit-Learn-Frameworks zu vermitteln und dabei die theoretischen Grundlagen mit praktischen Anwendungen zu verbinden. Von den ersten Schritten der Auseinandersetzung mit den Kernannahmen, die linearen Regressionsmodellen zugrunde liegen, bis hin zu den praktischen Übungen der Datenvorbereitung, Modellbildung und Interpretation der Ergebnisse haben wir einen Weg beschritten, der Theorie mit Praxis, Erkenntnisse mit Anwendung verbindet.
Scikit-learn hat sich mit seiner umfangreichen Sammlung an Tools und Algorithmen als unschätzbar wertvoller Verbündeter auf diesem Weg erwiesen. Seine benutzerfreundliche API und umfangreiche Dokumentation haben komplexe statistische Analysen entmystifiziert und die Leistungsfähigkeit der linearen Regression für alle zugänglich gemacht, die die in ihren Daten verborgenen Muster entschlüsseln möchten.
Die hier hervorgehobenen realen Anwendungen – von der Vorhersage von Immobilienpreisen über die Prognose von Verkäufen bis hin zur Verbesserung des Gesundheitswesens und der Optimierung landwirtschaftlicher Erträge – unterstreichen die allgegenwärtige Wirkung der linearen Regression bei der Förderung fundierter Entscheidungen in verschiedenen Sektoren. Diese Erzählungen veranschaulichen den Nutzen der linearen Regression und feiern die transformative Kraft der Datenwissenschaft in der Gesellschaft.
Lassen Sie die Reise zum Abschluss dieses umfassenden Leitfadens nicht hier enden. Das Gebiet der linearen Regression, insbesondere innerhalb des Scikit-Learn-Ökosystems, ist umfangreich und birgt Potenzial für Erkundungen. Ich ermutige Sie, tiefer einzutauchen, mit Ihren Datensätzen zu experimentieren und herauszufinden, wie lineare Regression das Unbekannte beleuchten, strategische Entscheidungen leiten und zum Wohl der Allgemeinheit beitragen kann.
Empfohlene Artikel
Entdecken Sie weitere Erkenntnisse und bereichern Sie Ihre Data-Science-Reise mit unseren anderen ausführlichen Artikeln zu ähnlichen Themen.
- Was ist Regressionsanalyse? Ein umfassender Leitfaden für Anfänger
- So melden Sie Ergebnisse der multiplen linearen Regression im APA-Stil
- So melden Sie einfache lineare Regressionsergebnisse im APA-Stil
- Annahmen in der linearen Regression: Ein umfassender Leitfaden
- Wie berechnet man Residuen in der Regressionsanalyse?
- Lineare Regressionsanalyse: Zeichnen von Linien in R
Häufig gestellte Fragen (FAQs)
Frage 1: Wie führt man eine lineare Regression mit Scikit durch?Verwenden Sie die Klasse 'LinearRegression' von scikit-learn, um Beziehungen zwischen unabhängigen und abhängigen Variablen effizient zu modellieren und vorherzusagen.
Frage 2: Was ist ein linearer Regressions-Score?Der Score bezieht sich auf das Bestimmtheitsmaß R² der Vorhersage, welches den Anteil der Varianz in der abhängigen Variablen misst, der durch die unabhängige(n) Variable(n) vorhergesagt werden kann.
Frage 3: Wie importiert man eine lineare Regression in Python?Verwenden Sie 'from sklearn.linear_model import LinearRegression', um die Klasse 'LinearRegression' aus dem Modul 'linear_model' von scikit-learn zu importieren.
Frage 4: Was sind Achsenabschnitt und Koeffizient einer linearen Regression in Python?Der Achsenabschnitt ist der Wert der abhängigen Variable, wenn alle unabhängigen Variablen null sind. Die Koeffizienten sind die Werte, die mit den Werten der unabhängigen Variablen multipliziert werden und deren Beziehung zur abhängigen Variable darstellen.
Frage 5: Wie interpretiere ich lineare Regressionskoeffizienten in Scikit-Learn?Die Koeffizienten geben die erwartete Veränderung der abhängigen Variable bei einer Änderung jeder unabhängigen Variable um eine Einheit an, wobei die anderen Variablen konstant gehalten werden.
Frage 6: Was ist Overfitting und wie lässt es sich beheben?Overfitting tritt auf, wenn ein Modell Rauschen statt des zugrundeliegenden Musters erfasst. Techniken wie Kreuzvalidierung und Regularisierung in scikit-learn mindern dieses Problem.
Frage 7: Kann die lineare Regression kategoriale Variablen verarbeiten?Mithilfe von Techniken wie One-Hot-Encoding lassen sich kategoriale Variablen effektiv in lineare Regressionsmodelle in scikit-learn integrieren.
Frage 8: Wie validiere ich ein lineares Regressionsmodell?Die Validierung umfasst die Anwendung von Techniken wie der Kreuzvalidierung und die Bewertung von Leistungskennzahlen wie R² und RMSE, um die Genauigkeit und Zuverlässigkeit des Modells sicherzustellen.
Frage 9: Wie kann die Genauigkeit eines linearen Regressionsmodells verbessert werden?Die Genauigkeit kann durch Feature Engineering verbessert werden, z. B. durch die Auswahl relevanter Variablen und die Anwendung von Regularisierungstechniken wie Ridge oder Lasso, um Überanpassung zu reduzieren und die Modellleistung zu verbessern.
Frage 10: Was sind einige typische Anwendungsgebiete der linearen Regression in der Praxis?Die lineare Regression findet breite Anwendung in der Prognose (z. B. von Umsätzen und Wettervorhersagen), der Risikobewertung im Finanz- und Versicherungswesen sowie der Auswertung von Trends und Zusammenhängen in der wissenschaftlichen Forschung und demonstriert damit ihre Vielseitigkeit in verschiedenen Bereichen.