Was ist Regressionsanalyse? Ein umfassender Leitfaden für Anfänger
Die Regressionsanalyse ist eine statistische Technik, die zur Modellierung der Beziehung zwischen der abhängigen Variablen und einer oder mehreren unabhängigen Variablen verwendet wird und so Vorhersagen, Entscheidungen und Erkenntnisse in verschiedenen Bereichen ermöglicht.
Highlights
- Die Regressionsanalyse modelliert Beziehungen zwischen abhängigen und unabhängigen Variablen für Vorhersagen und Entscheidungsfindung.
- Lineare, logistische und polynomielle Regression sind Schlüsseltypen der Regression, die jeweils für unterschiedliche Daten und Ziele geeignet sind.
- Anpassungsgütemetriken wie R-Quadrat und angepasstes R-Quadrat bewerten die Modellleistung und Erklärbarkeit.
- Zu den Regressionsannahmen gehören Linearität, Normalität, Fehlerunabhängigkeit und Homoskedastizität, die validiert werden müssen.
- Zu den häufigsten Fallstricken gehören verwirrende Korrelationen mit Kausalität, Überanpassung, Multikollinearität, ausgelassene Variablenverzerrung und Extrapolation.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Was ist eine Regressionsanalyse?
Die Regressionsanalyse ist eine grundlegende Technik in Statistik und Datenwissenschaft, die es ermöglicht, die Beziehungen zwischen Variablen zu untersuchen und zu quantifizieren. Sie wird eingesetzt, um Ergebnissevorherzusagen , Trendszu erkennen und datengestützte Entscheidungen in verschiedenen Bereichen zu treffen, von Wirtschaft und Finanzen bis hin zu Gesundheitswesen und Ingenieurwesen.
Im Kern zielt die Regressionsanalyse darauf ab, die relationship zwischen einer abhängigen Variable (der Variable, die wir vorhersagen oder erklären möchten) und einer oder mehreren unabhängigen Variablen (den Faktoren, die die abhängige Variable beeinflussen) zu modellieren. Dadurch gewinnen wir Einblicke in die zugrunde liegenden Muster und Kausalzusammenhänge unserer Daten und können so bessere Vorhersagen treffen und fundiertere Entscheidungen.
Die grundlegende Idee der Regressionsanalyse besteht darin, das am besten passende Modell zu finden , das die Beziehung zwischen abhängigen und unabhängigen Variablen präzise abbildet. Dies beinhaltet häufig das Anpassen einer Geraden oder Kurve an die Datenpunkte, um die Differenzen zwischen den beobachteten und den vorhergesagten Werten, die sogenannten Residuen, zu minimieren.
In der Praxis kann die Regressionsanalyse viele Formen annehmen, von der einfache lineare Regression, die die Beziehung zwischen einer abhängigen und einer unabhängigen Variable modelliert, bis hin zu fortgeschritteneren Techniken wie der multiplen Polynomregression, die die Analyse komplexerer Beziehungen ermöglichen.
Als vielseitiges und leistungsstarkes statistisches Werkzeugist die Regressionsanalyse unerlässlich für alle, die Daten interpretieren und aussagekräftige Schlussfolgerungen ziehen möchten. In diesem Leitfaden lernen Sie die verschiedenen Arten der Regressionsanalyse, ihre grundlegenden Konzepte, wichtigsten Annahmen und Grenzensowie praktische Anwendungen in verschiedenen Branchen kennen. Indem Sie die Regressionsanalyse verstehen und ihre Techniken beherrschen, sind Sie bestens gerüstet, um komplexe Datenherausforderungen zu meistern und datengestützte Entscheidungen sicher zu treffen.
Arten der Regressionsanalyse
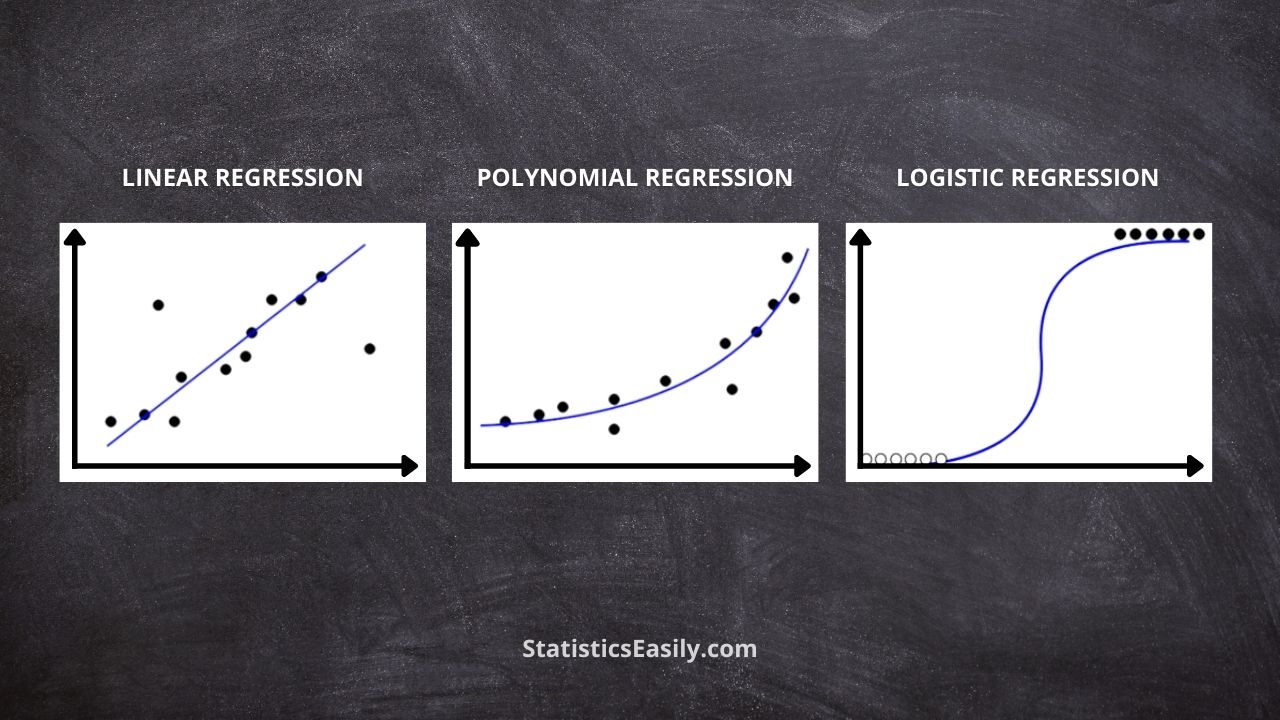
Lineare Regression:Dies ist die einfachste Form der Regressionsanalyse zur Modellierung des Zusammenhangs zwischen abhängigen und unabhängigen Variablen. Sie geht von einem linearen Zusammenhang zwischen den Variablen aus, der durch eine Gerade dargestellt wird. Ziel ist es, die Ausgleichsgerade zu finden, die die Summe der quadrierten Differenzen zwischen beobachteten und vorhergesagten Werten minimiert. Die lineare Regression wird häufig für Prognosen, Trendanalysen und die Bestimmung des Einflusses einer Variablen auf eine andere verwendet.
Logistische Regression:Diese Regressionsanalyse eignet sich für Probleme mit kategorialen abhängigen Variablen, darunter binäre (zwei mögliche Ergebnisse), nominale (ungeordnete Kategorien) und ordinale (geordnete Kategorien). Anstatt den tatsächlichen Wert der abhängigen Variable vorherzusagen, schätzt die logistische Regression die Wahrscheinlichkeit des Eintretens eines Ereignisses auf Basis der unabhängigen Variable. Sie verwendet die logistische Funktion, die die Ausgabe des Regressionsmodells in einen Wahrscheinlichkeitswert zwischen 0 und 1 umwandelt. Die logistische Regression findet häufig Anwendung in Bereichen wie der medizinischen Forschung, dem Marketing und dem Finanzwesen und ist vielseitig einsetzbar, um die Wahrscheinlichkeit bestimmter Ereignisse oder Ergebnisse vorherzusagen und den Einfluss verschiedener Faktoren auf diese Ergebnisse zu verstehen.
Polynomregression:Dies ist eine Erweiterung der linearen Regression, die angewendet wird, wenn die Beziehung zwischen abhängigen und unabhängigen Variablen nichtlinear ist. Anstelle einer Geraden wird eine Polynomfunktion verwendet, um die Krümmung dieser Beziehung zu modellieren. Die Polynomregression kann komplexere Muster in den Daten erfassen und bietet eine bessere Anpassung in Situationen, in denen lineare Modelle unzureichend sind. Es ist jedoch wichtig, den Grad des Polynoms sorgfältig zu wählen, da zu komplexe Modelle zu Überanpassung und einer schlechten Generalisierbarkeit auf neue Daten führen können.
*Regression: Die multiple Regression ist eine fortgeschrittene Methode, die die Einbeziehung mehrerer unabhängiger Variablen ermöglicht. Dadurch lassen sich komplexere Zusammenhänge zwischen Variablen analysieren und Störfaktoren kontrollieren. Sie ist nicht nur eine Verallgemeinerung der linearen Regression, sondern kann auch auf andere Regressionsarten wie die logistische und die polynomische Regression angewendet werden. Ziel der multiplen Regression ist es, das am besten passende Modell zu finden, das den Zusammenhang zwischen abhängigen und unabhängigen Variablen erklärt.
Die grundlegenden Konzepte der Regressionsanalyse
Abhängige und unabhängige Variablen:In der Regressionsanalyse ist die abhängige Variable (die Zielvariable) das Ergebnis, das wir vorhersagen oder erklären möchten. Gleichzeitig sind die unabhängigen Variablen (auch Prädiktoren, Merkmale oder erklärende Variablen genannt) die Faktoren, die die abhängige Variable beeinflussen. Ziel der Regressionsanalyse ist es, die Beziehung zwischen diesen Variablen zu modellieren, um die Auswirkungen der unabhängigen Variablen auf die abhängige Variable zu verstehen und Vorhersagen zu treffen.
Koeffizienten und Achsenabschnitte:Koeffizienten und Achsenabschnitte sind wesentliche Bestandteile eines Regressionsmodells. Die Koeffizienten beschreiben den Einfluss der unabhängigen Variablen auf die abhängige Variable und geben an, wie stark sich die abhängige Variable bei jeder Erhöhung der unabhängigen Variablen um eine Einheit verändert, vorausgesetzt, alle anderen Variablen bleiben konstant. Der Achsenabschnitt repräsentiert den Erwartungswert der abhängigen Variable, wenn alle unabhängigen Variablen gleich null sind. Diese Werte werden während der Modellanpassung mittels der Methode der kleinsten Quadrate oder der Maximum-Likelihood-Schätzung ermittelt.
Güte der Anpassung und R²: Die Güte der Anpassung misst, wie gut das Regressionsmodell zu den beobachteten Daten passt. Verschiedene Kennzahlen können zur Beurteilung der Anpassungsgüte herangezogen werden. Eine der gebräuchlichsten ist das R² (auch bekannt als Bestimmtheitsmaß). Das R² gibt den Anteil der Varianz der abhängigen Variable an, der durch die unabhängigen Variablen des Modells erklärt wird. Es liegt zwischen 0 und 1, wobei höhere Werte eine bessere Anpassung anzeigen. Bei der multiplen Regression ist es wichtig, das korrigierte R² zu berücksichtigen, das die Anzahl der unabhängigen Variablen im Modell einbezieht. Der R²-Wert kann mit zunehmender Anzahl an Variablen steigen, selbst wenn diese nicht wesentlich zur Vorhersagekraft des Modells beitragen. Das korrigierte R² korrigiert dieses Problem, indem es den R²-Wert für die Einbeziehung unnötiger Variablen bestraft. Dies führt zu einer genaueren Beurteilung der Modellleistung und hilft, Überanpassung zu vermeiden. Sowohl das R² als auch das korrigierte R² sollten jedoch mit Vorsicht interpretiert werden, da ein hoher Wert kein gutes Modell garantiert. Das Modell kann weiterhin anfällig für Probleme wie Multikollinearität, Verzerrungen durch ausgelassene Variablen oder andere Verletzungen der Regressionsannahmen sein.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Wichtige Annahmen und Einschränkungen
Die Regressionsanalyse basiert auf mehreren Schlüsselannahmen, die bei verschiedenen Regressionstypen üblich sind, einschließlich linearer, logistischer, polynomialer und multipler Regressionserweiterungen. Wenn diese Annahmen nicht erfüllt sind, kann die Genauigkeit und Gültigkeit der Vorhersagen und Schlussfolgerungen des Modells eingeschränkt sein. Daher ist es wichtig, diese Annahmen bei der Durchführung einer Regressionsanalyse zu verstehen und zu bewerten.
Geeignete Funktionsform:Die Beziehung zwischen abhängigen und unabhängigen Variablen sollte der Funktionsform des Regressionsmodells entsprechen. Dies bedeutet eine lineare Beziehung bei linearer Regression, während bei polynomialer Regression eine polynomiale Beziehung angenommen wird. Streudiagramme oder Residuenplots können helfen, Verletzungen dieser Annahme zu erkennen.
Unabhängigkeit der Beobachtungen:Die Beobachtungen in einem Datensatz sollten voneinander unabhängig sein. Bei Autokorrelation (wenn aufeinanderfolgende Beobachtungen miteinander korreliert sind) kann das Regressionsmodell die tatsächliche Variabilität der Daten unterschätzen, was zu unzuverlässigen Koeffizientenschätzungen und Hypothesentests führt.
Unabhängigkeit der Fehler:Die Residuen (Fehler) sollten unabhängig sein, d. h. der Fehler einer Beobachtung sollte den Fehler einer anderen nicht beeinflussen. Sind die Fehler korreliert, können die Standardfehler der Koeffizienten unterschätzt werden, was zu falschen Schlussfolgerungen und Konfidenzintervallen führt.
Homoskedastizität (bei linearer und polynomialer Regression):Die Restvarianz sollte über alle Stufen der unabhängigen Variablen hinweg konstant sein. Ändert sich die Varianz (ein Phänomen, das als Heteroskedastizität bezeichnet wird), können die Standardfehler der Koeffizienten verzerrt sein, was Hypothesentests und Konfidenzintervalle beeinflusst.
Normalverteilung der Residuen (bei linearer und polynomialer Regression):Die Residuen (d. h. die Differenzen zwischen den beobachteten und den vorhergesagten Werten) sollten einer Normalverteilung folgen. Abweichungen von der Normalverteilung können Hypothesentests und die Gültigkeit von Konfidenzintervallen beeinträchtigen.
Keine Multikollinearität:Die unabhängigen Variablen sollten nicht stark miteinander korreliert sein. Multikollinearität kann zu instabilen Koeffizientenschätzungen führen und die Interpretation der individuellen Beiträge jeder Variablen erschweren.
Korrekt spezifizierte Linkfunktion (für logistische Regression):Die Linkfunktion muss in der logistischen Regression korrekt definiert sein, um die vorhergesagten Werte in Wahrscheinlichkeiten umzuwandeln. Die Verwendung einer falschen Linkfunktion kann zu verzerrten Koeffizientenschätzungen und ungenauen Vorhersagen führen.
Interpretation der Ergebnisse der Regressionsanalyse
Das Verstehen und Interpretieren der Ergebnisse der Regressionsanalyse ist entscheidend, um bessere Entscheidungen zu treffen und aussagekräftige Schlussfolgerungen zu ziehen. Hier sind einige wichtige Aspekte, die bei der Interpretation der Ergebnisse eines Regressionsmodells, einschließlich linearer, logistischer, polynomialer und multipler Regression, zu berücksichtigen sind:
Koeffizientenschätzungen:Die Koeffizienten geben den Einfluss jeder unabhängigen Variable auf die abhängige Variable an, wobei alle anderen Variablen konstant gehalten werden. In der linearen und polynomialen Regression zeigen die Koeffizienten die Veränderung der abhängigen Variable bei einer Erhöhung der unabhängigen Variable um eine Einheit an. In der logistischen Regression geben die Koeffizienten die Veränderung des Logarithmus der Wahrscheinlichkeit (log Odds) des Ergebnisses bei einer Erhöhung der unabhängigen Variable um eine Einheit an.
Signifikanz der Koeffizienten:Hypothesentests wie t-Tests oder z-Tests werden durchgeführt, um die statistische Signifikanz der Koeffizienten zu bestimmen. Ein statistisch signifikanter Koeffizient deutet darauf hin, dass die unabhängige Variable einen relevanten Einfluss auf die abhängige Variable hat. Ein nicht signifikanter Koeffizient impliziert, dass die unabhängige Variable möglicherweise keinen signifikanten Beitrag zum Modell leistet.
Konfidenzintervalle:Konfidenzintervalle schätzen den Bereich, in dem der Populationskoeffizient wahrscheinlich liegt. Engere Intervalle deuten auf präzisere Schätzungen hin, während breitere Intervalle eine größere Unsicherheit.
Gütekriterien für das Modell:Kennzahlen wie das Bestimmtheitsmaß (R²), das korrigierte Bestimmtheitsmaß (korrigiertes R²) oder das Akaike-Informationskriterium (AIC) helfen bei der Beurteilung der Gesamtleistung des Modells. Diese Kennzahlen sollten zusammen mit anderen Diagnoseverfahren und Diagrammen betrachtet werden, um die Eignung des Modells zu bewerten.
Residuenanalyse:Die Untersuchung der Residuen kann Muster oder Trends aufdecken, die auf Verletzungen der Regressionsannahmen oder Bereiche hinweisen, in denen das Modell die Daten nicht gut abbildet. Residuenplots, Normalverteilungsplots und Autokorrelationsplots können verwendet werden, um potenzielle Probleme zu diagnostizieren und die Modellverbesserung zu steuern.
Ausreißer und einflussreiche Punkte:Ausreißer und einflussreiche Punkte können das Regressionsmodell erheblich beeinflussen. Durch deren Identifizierung und Behandlung – beispielsweise durch Ausschluss oder Anwendung robuster Regressionsverfahren – lässt sich die Modellleistung verbessern.
Validierung und Generalisierung: Mithilfe von Kreuzvalidierung oder Hold-out-Validierung kann die Leistung des Modells anhand neuer Daten bewertet werden. Dies hilft, die Generalisierbarkeit einzuschätzen und Überanpassung zu vermeiden.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Praktische Anwendungen der Regressionsanalyse
Die Regressionsanalyse ist ein leistungsstarkes statistisches Tool mit vielen praktischen Anwendungen in verschiedenen Branchen. Die Regressionsanalyse kann dabei helfen, Entscheidungen zu treffen, Prozesse zu optimieren und zukünftige Ergebnisse vorherzusagen, indem sie die Beziehung zwischen den abhängigen und unabhängigen Variablen modelliert. Hier sind einige Beispiele dafür, wie die Regressionsanalyse in verschiedenen Branchen eingesetzt wird:
Finanzen und Wirtschaft:Im Finanzwesen kann die Regressionsanalyse genutzt werden, um den Zusammenhang zwischen Aktienkursen und Wirtschaftsindikatoren wie Zinssätzen oder Arbeitslosenquoten zu modellieren. Dies kann Anlegern helfen, bessere Entscheidungen hinsichtlich Portfolioallokation und Risikomanagement zu treffen. Darüber hinaus können Ökonomen die Regression einsetzen, um die Auswirkungen der Geld- und Fiskalpolitik auf Wirtschaftswachstum und Inflation zu untersuchen.
Marketing und Vertrieb:Regressionsmodelle können eingesetzt werden, um die Effektivität von Marketingkampagnen zu analysieren, das Konsumverhalten zu verstehen und Umsätze vorherzusagen. Unternehmen können beispielsweise mithilfe von Regressionsmodellen die Auswirkungen von Werbeausgaben auf den Umsatz ermitteln und so ihr Marketingbudget optimieren, um einen maximalen Return on Investment zu erzielen.
Gesundheitswesen:Die Regressionsanalyse untersucht den Zusammenhang zwischen Patientenmerkmalen und Gesundheitsergebnissen im Gesundheitswesen. Dies kann helfen, Krankheitsrisikofaktoren zu identifizieren, Behandlungsentscheidungen zu fundieren und die Patientenversorgung zu optimieren. Beispielsweise kann die logistische Regression die Wahrscheinlichkeit vorhersagen, mit der ein Patient eine bestimmte Erkrankung entwickelt, basierend auf demografischen und klinischen Variablen.
Fertigung und Qualitätskontrolle:Regressionsanalysen ermöglichen die Optimierung von Fertigungsprozessen, die Verbesserung der Produktqualität und die Senkung der Produktionskosten. Durch die Modellierung des Zusammenhangs zwischen Prozessvariablen und Produkteigenschaften können Unternehmen die optimalen Bedingungen für die Erreichung der gewünschten Produktspezifikationen bei gleichzeitiger Minimierung von Abfall und Ressourcenverbrauch ermitteln.
Personalwesen:Im Personalmanagement kann die Regressionsanalyse genutzt werden, um die Faktoren zu verstehen, die die Leistung, die Mitarbeiterbindung und die Arbeitszufriedenheit beeinflussen. Dies kann Unternehmen dabei helfen, gezielte Strategien für Rekrutierung, Weiterbildung und Mitarbeiterbindung zu entwickeln und letztendlich die Produktivität zu steigern und die Fluktuation zu senken.
Sportanalyse:Regressionsmodelle werden in der Sportanalyse zunehmend eingesetzt, um die Leistung von Spielern zu bewerten, Trainerentscheidungen zu unterstützen und Teamstrategien zu optimieren. Beispielsweise kann die multiple Regressionsanalyse den Beitrag einzelner Spielerstatistiken zum Teamerfolg quantifizieren und Trainern und Managern so helfen, fundiertere Kaderentscheidungen zu treffen.
Umweltwissenschaften: In der ökologischen Forschung kann die Regressionsanalyse eingesetzt werden, um den Zusammenhang zwischen Umweltfaktoren wie Temperatur oder Niederschlag und ökologischen Ergebnissen wie Artenverteilung oder Ökosystemproduktivität zu modellieren. Dies kann Naturschutzmaßnahmen, das Management natürlicher Ressourcen und die Politikentwicklung unterstützen.
Häufige Fallstricke und Missverständnisse bei der Regressionsanalyse
Obwohl die Regressionsanalyse ein leistungsstarkes und weit verbreitetes statistisches Tool ist, birgt sie Herausforderungen und potenzielle Fallstricke. Sich dieser häufigen Missverständnisse und Probleme bewusst zu sein, kann Praktikern dabei helfen, Fehler zu vermeiden und die Qualität ihrer Analyse zu verbessern:
Korrelation vs. Kausalität:Ein häufiges Missverständnis in der Regressionsanalyse ist die Annahme, dass Korrelation Kausalität impliziert. Zwar kann die Regression Beziehungen zwischen Variablen aufzeigen, beweist aber nicht zwangsläufig einen kausalen Zusammenhang. Der Nachweis von Kausalität erfordert ein tieferes Verständnis der zugrunde liegenden Mechanismen und beinhaltet oft experimentelle Designs oder zusätzliche Analysen.
Überanpassung:Ein zu komplexes Modell oder eines mit zu vielen unabhängigen Variablen kann zu Überanpassung führen. Dabei erfasst das Modell eher Rauschen in den Daten als die zugrundeliegenden Zusammenhänge. Überangepasste Modelle liefern bei neuen Daten schlechte Ergebnisse und können zu irreführenden Schlussfolgerungen führen. Um Überanpassung zu vermeiden, empfiehlt sich die Anwendung von Kreuzvalidierung, Regularisierung oder Modellauswahl anhand von Informationskriterien wie AIC oder BIC.
Multikollinearität:Sind unabhängige Variablen stark korreliert, lässt sich der individuelle Beitrag jeder Variablen zum Modell nur schwer interpretieren. Multikollinearität kann zu instabilen Schätzungen und erhöhten Standardfehlern führen. Die Erkennung von Multikollinearität mithilfe von Varianzinflationsfaktoren (VIFs) oder Korrelationsmatrizen sowie deren Behebung durch Techniken wie Variablenauswahl oder Dimensionsreduktion können die Modellinterpretation und -leistung verbessern.
Verzerrung durch ausgelassene Variablen:Werden wichtige Variablen aus dem Regressionsmodell ausgeschlossen, kann dies zu verzerrten Koeffizientenschätzungen und irreführenden Schlussfolgerungen führen. Um eine solche Verzerrung zu vermeiden, stellen Sie sicher, dass alle relevanten Variablen in die Analyse einbezogen werden. Ziehen Sie die Verwendung schrittweiser Regression oder Modellselektionsverfahren in Betracht, um die wichtigsten Prädiktoren zu identifizieren.
Verletzung von Annahmen:Werden die grundlegenden Annahmen der Regressionsanalyse ignoriert oder nicht überprüft, kann dies zu unzuverlässigen Ergebnissen führen. Es ist unerlässlich, die Gültigkeit der Annahmen, wie Linearität, Unabhängigkeit der Fehler und Homoskedastizität, zu prüfen und gegebenenfalls alternative Verfahren oder Transformationen anzuwenden.
Extrapolation:Die Verwendung von Regressionsmodellen zur Vorhersage von Daten außerhalb des beobachteten Bereichs kann riskant sein, da die Beziehungen zwischen den Variablen in nicht beobachteten Bereichen möglicherweise nicht gelten. Seien Sie bei der Extrapolation von Vorhersagen vorsichtig und berücksichtigen Sie die Grenzen des Modells sowie mögliche unvorhergesehene Einflussfaktoren.
Fehlinterpretation von Koeffizienten: Die Interpretation von Regressionskoeffizienten ohne Berücksichtigung der Skala der Variablen oder der Linkfunktion (im Falle der logistischen Regression) kann zu Verwirrung und falschen Schlussfolgerungen führen. Stellen Sie sicher, dass die Interpretation der Koeffizienten kontextgerecht ist und die Maßeinheiten, die Wirkungsrichtung und die Stärke des Zusammenhangs berücksichtigt.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Fazit
Die Regressionsanalyse ist ein leistungsstarkes und vielseitiges statistisches Tool, mit dem Praktiker die Beziehungen zwischen Variablen modellieren, Vorhersagen treffen und Entscheidungen in verschiedenen Branchen treffen können. Durch das Verständnis der grundlegenden Konzepte wie abhängige und unabhängige Variablen, Koeffizienten und Anpassungsgüte können Analysten den geeigneten Typ von Regressionsmodell für ihre Daten auswählen, einschließlich linearer, logistischer, polynomialer und multipler Regression.
Es ist jedoch wichtig, sich der Annahmen und Einschränkungen der Regressionsanalyse bewusst zu sein und die Ergebnisse sorgfältig zu interpretieren, um häufige Fallstricke und Missverständnisse zu vermeiden. Durch die Berücksichtigung der Annahmen, die Behandlung von Problemen wie Multikollinearität und Überanpassung sowie den Einsatz von Techniken wie Kreuzvalidierung und Regularisierung können Praktiker genauere und verallgemeinerbare Modelle erstellen, die wertvolle Erkenntnisse liefern und die datengesteuerte Entscheidungsfindung vorantreiben.
Zusammenfassend lässt sich sagen, dass die Regressionsanalyse ein unschätzbares Werkzeug zum Verständnis komplexer Zusammenhänge und zur Lösung realer Probleme ist, sofern sich die Praktiker ihrer potenziellen Herausforderungen und Einschränkungen bewusst sind und sich dazu verpflichten, die Methode verantwortungsbewusst und effektiv einzusetzen.
Empfohlene Artikel
Möchten Sie Ihr Wissen erweitern? In unserem Blog finden Sie weitere relevante Artikel, die Ihr Verständnis dieser wichtigen statistischen Tests vertiefen. Nutzen Sie die Gelegenheit, Ihre Datenanalysefähigkeiten zu verbessern Datenanalyse fundiertere Entscheidungen zu treffen. Jetzt lesen!
- So melden Sie Ergebnisse der multiplen linearen Regression im APA-Stil
- So melden Sie einfache lineare Regressionsergebnisse im APA-Stil
- Annahmen in der linearen Regression: Ein umfassender Leitfaden
- Logistische Regression mit R: Der endgültige Leitfaden
- Was sind die Annahmen der logistischen Regression?
- Was sind die drei Arten der logistischen Regression?
- So erstellen Sie Regressionslinien in Excel
- Die logistische Regression meistern (Geschichte)
FAQ: Was ist Regressionsanalyse?
Die Regressionsanalyse ist ein statistischer Ansatz zur Modellierung von Beziehungen zwischen abhängigen und unabhängigen Variablen zur Vorhersage und Entscheidungsfindung.
Die Haupttypen sind lineare, logistische, polynomielle und multiple Regression, die jeweils für unterschiedliche Datentypen und Ziele geeignet sind.
Korrelation misst die Stärke und Richtung einer Beziehung zwischen Variablen. Gleichzeitig bedeutet Kausalität, dass eine Variable die andere direkt beeinflusst.
Zu den Annahmen gehören Linearität, Normalität, Fehlerunabhängigkeit und Homoskedastizität, die für zuverlässige Ergebnisse validiert werden müssen.
Wenn unabhängige Variablen stark korreliert sind, kommt es zu Multikollinearität, was die Interpretation einzelner Beiträge erschwert. Es kann mithilfe von Variablenauswahl- oder Dimensionsreduktionstechniken angegangen werden.
Überanpassung tritt auf, wenn ein Modell Rauschen anstelle zugrunde liegender Beziehungen erfasst, was zu einer schlechten Generalisierbarkeit führt. Dies kann durch Kreuzvalidierung, Regularisierung oder Modellauswahl verhindert werden.
Koeffizienten stellen die Wirkung unabhängiger Variablen auf die abhängige Variable dar, während andere Variablen konstant bleiben. Die Interpretation hängt von der Art der Regression und den Variablenskalen ab.
Bei der Residuenanalyse werden Residuen (Differenzen zwischen beobachteten und vorhergesagten Werten) untersucht, um Muster, Trends oder Verstöße gegen Regressionsannahmen zu identifizieren und so die Modellverbesserung voranzutreiben.
Die Regressionsanalyse wird häufig in den Bereichen Finanzen, Marketing, Gesundheitswesen, Fertigung, Personalwesen, Sportanalytik und Umweltwissenschaften eingesetzt.
Zu den häufigsten Fallstricken gehören die verwirrende Korrelation mit der Kausalität, Überanpassung, Multikollinearität, ausgelassene Variablenverzerrung, Extrapolation und die Fehlinterpretation von Koeffizienten.