Random Forest in der Praxis: Ein wesentlicher Leitfaden
Sie erfahren, wie Random Forest Entscheidungsbäume nutzt, um die Vorhersagegenauigkeit in komplexen Datensätzen zu verbessern.
Einführung
Zufälliger Waldist ein wichtiger Algorithmus des maschinellen Lernens, der in der Datenwissenschaft aufgrund seiner Effektivität bei Klassifizierungs- und Regressionsaufgaben große Beliebtheit erlangt hat. Sein Erfolg beruht im Wesentlichen auf der Fähigkeit, während des Trainingsprozesses mehrere Entscheidungsbäume zu erstellen und den Modalwert der Klassen (Klassifizierung) bzw. die mittlere Vorhersage (Regression) der einzelnen Bäume auszugeben. Diese Einführung soll Random Forests für Anfänger verständlich machen, indem sie eine klare, schrittweise Erklärung der Funktionsweise sowie eine praktische Anleitung zur Implementierung in Pythonbietet . Unser Ziel ist es, den Lesern das nötige Wissen zu vermitteln, um die theoretischen Grundlagen von Random Forest zu verstehen und ihn mithilfe der leistungsstarken Programmierfunktionen von Python effektiv in ihren Datenwissenschaftsprojekten anzuwenden.
Highlights
- Random Forest übertrifft einzelne Entscheidungsbäume, indem es die Überanpassung reduziert.
- Die Optimierung der Hyperparameter in Random Forest verbessert die Modellgenauigkeit entscheidend.
- Die Datenvorverarbeitung ist entscheidend für den Vorhersageerfolg von Random Forest.
- Eine Schritt-für-Schritt-Python-Anleitung vereinfacht die Random Forest-Implementierung.
- Die Bewertung von Random Forest-Modellen erfordert Genauigkeit, Präzision und Rückrufmetriken.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Random Forest verstehen
Zufälliger Waldist ein Algorithmus des maschinellen Lernens, der auf dem Konzept von Entscheidungsbäumen aufbaut, um ein genaueres und robusteres Vorhersagemodell zu erstellen. Während des Trainings werden zahlreiche Entscheidungsbäume generiert. Als Ergebnis gibt der Algorithmus die Klasse aus, d. h. den Modalwert der Klassen (bei der Klassifizierung) oder den Mittelwert der Vorhersagen (bei der Regression) der einzelnen Bäume.
So funktioniert Random Forest:
Entscheidungsbäume: Random Forest basiert auf Entscheidungsbäumen, einfachen, baumartigen Entscheidungsmodellen. Jeder Baum in einem Random Forest liefert eine Vorhersage, und der Algorithmus verwendet die Mehrheitsentscheidung oder im Falle einer Regression den Durchschnitt als endgültiges Ergebnis.
Bootstrapping: Bei dieser Technik wird für jeden Baum zufällig eine Teilmenge des Datensatzes ausgewählt. Dadurch wird die Diversität der Bäume sichergestellt und zur Robustheit des Modells beigetragen.
Aggregation (Bagging): Der Algorithmus aggregiert dann die Vorhersagen der einzelnen Bäume, um eine genauere und stabilere Vorhersage zu erzeugen.
Vorteile von Random Forest:
Reduziertes Overfitting: Im Gegensatz zu einzelnen Entscheidungsbäumen, die häufig unter Overfitting ihrer Trainingsdaten leiden, mindert Random Forest dieses Risiko durch seinen Ensemble-Ansatz. Die Mittelung der Vorhersagen zahlreicher Bäume stellt sicher, dass die Gesamtvorhersage des Modells nicht zu stark von einem einzelnen Teil der Trainingsdaten abhängt, was zu besser generalisierbaren Ergebnissen führt.
Hohe Genauigkeit: Die Stärke von Random Forest liegt in der Aggregation von Vorhersagen mehrerer Entscheidungsbäume, die jeweils mit unterschiedlichen Teilmengen derselben Daten trainiert wurden. Diese Ensemble-Methode steigert die Vorhersagegenauigkeit deutlich und übertrifft viele Einzelmodellansätze bei verschiedenen Datensätzen und Problemtypen.
Vielseitigkeit in der Anwendung: Dank seines Designs eignet sich Random Forest hervorragend für verschiedenste Aufgaben, von der Vorhersage kategorialer Ergebnisse in Klassifizierungsproblemen bis hin zur Schätzung kontinuierlicher Variablen in Regressionsanalysen. Die robuste Verarbeitung von Datensätzen mit fehlenden Werten und die Fähigkeit, numerische und kategoriale Daten ohne aufwendige Vorverarbeitung zu verarbeiten, machen ihn außerordentlich flexibel.
Erkenntnisse zur Merkmalswichtigkeit: Eine der herausragenden Fähigkeiten von Random Forest ist sein inhärenter Merkmalsauswahlmechanismus. Durch die Analyse des Einflusses jedes Merkmals auf die Vorhersagegenauigkeit über alle Bäume hinweg kann Random Forest die Wichtigkeit der Merkmale innerhalb des Datensatzes bestimmen. Diese Erkenntnis ist von unschätzbarem Wert, um die treibenden Faktoren hinter den Vorhersagen zu verstehen. Sie kann die Merkmalsauswahl bei der Modellverfeinerung und Datenanalyse unterstützen.
Anwendungen von Random Forest:
Finanzen: Random Forest wird im Finanzsektor umfassend für wichtige Aufgaben eingesetzt, wie z. B. die Bewertung des Kreditrisikos durch die Analyse von Kreditwürdigkeitswerten und die Prognose zukünftiger Bewegungen am Aktienmarkt, was Anlagestrategien unterstützt.
E-Commerce: Dieser Algorithmus verbessert das Online-Shopping-Erlebnis durch Empfehlungssysteme, die Produkte basierend auf dem Nutzerverhalten und den Präferenzen vorschlagen. Er spielt außerdem eine zentrale Rolle bei der Segmentierung von Kunden in verschiedene Gruppen für gezielte Marketing- und Werbestrategien.
Gesundheitswesen: Im medizinischen Bereich trägt Random Forest zur Früherkennung von Krankheiten bei, indem es Patientendaten auf Symptome analysiert, die auf bestimmte Erkrankungen hinweisen. Es hilft außerdem, Patienten in Risikogruppen einzuteilen und so personalisierte Behandlungspläne zu erstellen.
Cybersicherheit: Angesichts der zunehmenden Komplexität von Cyberbedrohungen unterstützt Random Forest die rechtzeitige Erkennung und Vorhersage potenzieller Betrugsfälle und Sicherheitsverletzungen, indem es die Anomalieerkennung in Datenmustern nutzt, um digitale Vermögenswerte zu schützen.
Random Forest-Theoretische Grundlagen
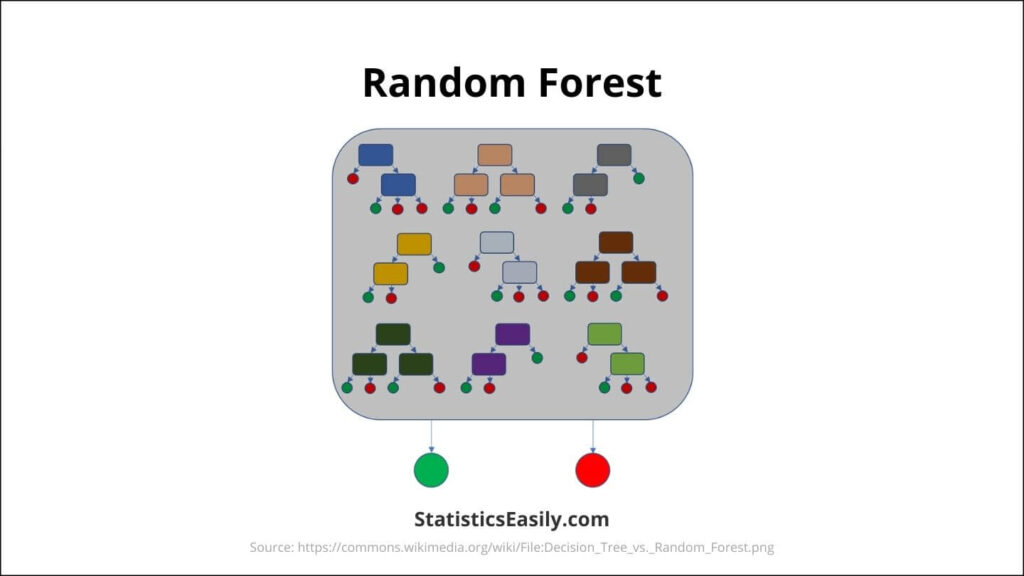
Zufälliger Wald-Algorithmus arbeitet nach dem Prinzip des Ensemble-Lernens, bei dem mehrere Klassifikatoren, in diesem Fall Entscheidungsbäume, kombiniert werden, um ein komplexes Problem zu lösen und die Leistung des Modells zu verbessern.
Detaillierte Erläuterung des Algorithmus:
Ensemble von Entscheidungsbäumen: Random Forest erzeugt einen Wald unkorrelierter Entscheidungsbäume, die jeweils anhand zufälliger Teilmengen der Trainingsdaten trainiert werden, unter Verwendung einer Bootstrapping-Technik.
Zufällige Merkmalsauswahl: Jeder Baum wählt bei jeder Aufteilung eine zufällige Teilmenge von Merkmalen aus. Diese Zufälligkeit trägt zu einer größeren Diversität der Bäume bei und erhöht somit die Gesamtgenauigkeit des Modells.
Aggregation: Die endgültige Vorhersage des Random Forest wird durch Aggregation der Vorhersagen einzelner Bäume ermittelt. Diese Aggregation reduziert die Varianz, beugt Überanpassung vor und verbessert die Vorhersagegenauigkeit des Modells.
Hyperparameter und ihre Auswirkungen:
Anzahl der Bäume (n_estimators): Eine Erhöhung der Anzahl der Bäume verbessert im Allgemeinen die Modellleistung, erhöht aber den Rechenaufwand.
Maximale Tiefe (max_depth): Steuert die Tiefe jedes Baums. Tiefere Bäume können komplexere Muster erfassen, können aber zu Überanpassung führen.
Minimale Stichprobenaufteilung (min_samples_split): Bestimmt die minimale Anzahl an Stichproben, die erforderlich sind, um einen internen Knoten aufzuteilen. Höhere Werte verhindern, dass das Modell zu spezifische Muster lernt.
Maximale Anzahl Merkmale (max_features): Die Größe der zufälligen Merkmalsmengen, die beim Aufteilen eines Knotens berücksichtigt werden. Sie beeinflusst die Diversität der Bäume im Wald.
Messung der Wirksamkeit:
Genauigkeit: Der Anteil der korrekt vorhergesagten Beobachtungen an der Gesamtzahl der Beobachtungen. Sie ist eine wertvolle Kennzahl für balancierte Klassifizierungsprobleme.
Konfusionsmatrix: Eine detaillierte Aufschlüsselung der Leistung des Modells, einschließlich richtig positiver, richtig negativer, falsch positiver und falsch negativer Ergebnisse.
Präzision, Trefferquote und F1-Score: Die Präzision ist das Verhältnis der korrekt vorhergesagten positiven Beobachtungen zu allen vorhergesagten positiven Beobachtungen. Die Trefferquote (Sensitivität) misst das Verhältnis der korrekt vorhergesagten positiven Beobachtungen zu allen Beobachtungen der tatsächlichen Klasse. Der F1-Score ist der gewichtete Durchschnitt von Präzision und Trefferquote. Diese Metriken sind insbesondere bei unausgewogenen Datensätzen von entscheidender Bedeutung.
Vorbereiten Ihrer Daten
Eine effektive Datenvorverarbeitung ist ein entscheidender Schritt beim maschinellen Lernen, der die Leistung von Modellen wie Random Forest erheblich beeinflusst. In diesem Abschnitt werden die wesentlichen Datenbereinigungs- und Vorbereitungsschritte beschrieben, um sicherzustellen, dass die Daten für die Random Forests-Modellierung optimal strukturiert sind.
Bedeutung der Datenvorverarbeitung:
Durch die Datenvorverarbeitung werden Rohdaten in einen sauberen Datensatz umgewandelt, der direkt für Modelle des maschinellen Lernens verwendet werden kann. Dieser Prozess ist von entscheidender Bedeutung, da er sich direkt auf die Fähigkeit des Modells auswirkt, zu lernen und genaue Vorhersagen zu treffen. Bei Random Forest, bei dem mehrere Entscheidungsbäume beteiligt sind, sorgt die Vorverarbeitung für Konsistenz und Qualität im gesamten Datensatz, sodass der Algorithmus Muster effektiver identifizieren kann.
Schritte zur Datenbereinigung und -vorbereitung:
1. Umgang mit fehlenden Werten: Random Forest kann fehlende Werte bis zu einem gewissen Grad verarbeiten. Es empfiehlt sich jedoch generell, fehlende Werte mithilfe von Strategien wie der Mittelwertimputation für numerische Merkmale und der Modusimputation für kategoriale Merkmale zu imputieren.
2. Kodierung kategorialer Variablen: Kategoriale Variablen müssen mithilfe von Kodierungstechniken wie One-Hot- oder Label-Kodierung in ein numerisches Format umgewandelt werden, da Random Forest keine rohen Textdaten verarbeiten kann.
3. Merkmalskalierung: Random Forest reagiert zwar nicht so empfindlich auf die Merkmalskalierung wie Algorithmen wie SVM oder KNN, aber die Sicherstellung, dass alle Merkmale auf der gleichen Skala liegen, kann die Modellkonvergenz und die Interpretierbarkeit der Merkmalswichtigkeitswerte verbessern.
4. Entfernen irrelevanter Merkmale: Eliminieren Sie Merkmale, die nicht zur Vorhersage beitragen oder Rauschen verursachen könnten. Obwohl Random Forest Merkmale während des Trainings zufällig auswählt, kann eine Reduzierung der Dimensionalität im Vorfeld die Trainingszeit und -komplexität verringern.
Aufteilen des Datensatzes:
Trainings- und Testdatensätze: Teilen Sie Ihre Daten in Trainings- und Testdatensätze auf, um die Leistung des Modells anhand unbekannter Daten zu bewerten. Ein typisches Aufteilungsverhältnis ist 70:30 oder 80:20, wobei der größere Teil für das Training verwendet wird.
Kreuzvalidierung: Ziehen Sie die Verwendung von Kreuzvalidierungsverfahren, insbesondere der k-fachen Kreuzvalidierung, in Betracht, um sicherzustellen, dass die Leistung des Modells über verschiedene Teilmengen der Daten hinweg konsistent ist.
Praktische Anwendung von Random Forest mit Python
Die Anwendung von Random Forest inPythonverbindet effektiv das theoretische Verständnis des Algorithmus mit praktischen Programmierkenntnissen. Dieser Abschnitt führt Sie durch die Einrichtung Ihrer Python-Umgebung, die Implementierung von Random Forest mithilfe dersklearn-Bibliothek und die Anwendung auf einen realen Datensatz.
Ein praktisches Beispiel: Vorhersage von Irisarten
Der Iris-Datensatz enthält 150 Irispflanzen, die anhand von vier Merkmalen in drei Arten eingeteilt werden: Kelchblattlänge, Kelchblattbreite, Blütenblattlänge und Blütenblattbreite. Das Random Forest-Modell lernt aus den Trainingsdaten und sagt die Art der Irispflanzen genau voraus.
Wenn Sie die folgenden Schritte ausführen, können Sie Random Forests in Python für verschiedene Datensätze implementieren, nicht nur für den Iris-Datensatz. Passen Sie die Hyperparameter des Modells an, z. B. n_estimators und max_ Depth, um die Leistung basierend auf Ihrem spezifischen Datensatz und Ihrer Aufgabe zu verbessern.
Die bereitgestellten Codeausschnitte sind so konzipiert, dass sie einfach zu befolgen sind, und enthalten Erläuterungen zu jedem Schritt, um das Verständnis und die Implementierung zu erleichtern. Diese praktische Anwendung demonstriert die Leistungsfähigkeit von Random Forests bei der Vorhersagemodellierung. Es bietet eine solide Grundlage für die Erforschung komplexerer Data-Science-Projekte.
Einrichten Ihrer Python-Umgebung
Um mit Random Forest in Python arbeiten zu können, stellen Sie sicher, dass Python auf Ihrem Computer installiert ist. Verwenden Sie die folgenden Pakete:
- NumPy: Zur Handhabung von Arrays und Matrizen.
- Pandas: Zur Datenmanipulation und -analyse.
- Scikit-learn (sklearn): Bietet den Random Forest-Algorithmus und zusätzliche Funktionen zum Erstellen von Vorhersagemodellen.
- Matplotlib/Seaborn: Zur Visualisierung von Daten und Modellergebnissen.
Installieren Sie diese Pakete mit pip:
pip install numpy pandas scikit-learn matplotlib seaborn
Random Forest mit sklearn implementieren
Das Modul sklearn.ensemble enthält den RandomForestClassifier für Klassifizierungsaufgaben und den RandomForestRegressor für Regressionsaufgaben. Hier ist eine Schritt-für-Schritt-Anleitung zur Verwendung von RandomForestClassifier:
1. Notwendige Bibliotheken importieren:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. Laden Sie Ihren Datensatz:Für dieses Beispiel verwenden wir den Iris-Datensatz, einen Klassiker unter den Beispielen für maschinelles Lernen.
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. Teilen Sie den Datensatz auf:Teilen Sie Ihre Daten in Trainings- und Testdatensätze auf, um die Leistung des Modells zu bewerten.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Modell initialisieren und trainieren:Erstellen Sie eine Instanz von RandomForestClassifier und passen Sie diese an Ihre Trainingsdaten an.
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. Vorhersagen treffen und das Modell bewerten:Verwenden Sie das trainierte Modell, um den Testdatensatz vorherzusagen und die Genauigkeit zu bewerten.
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
Modellergebnisse und Interpretation
Nachdem Sie das Modell trainiert und Vorhersagen getroffen haben, ist es wichtig, die Ergebnisse zu interpretieren, um seine Leistung zu verstehen und zu verstehen, wie es verbessert werden kann.
Bewertung der Modellleistung:Untersuchen Sie zunächst die Genauigkeit des Modells und betrachten Sie anschließend aussagekräftigere Kennzahlen.
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
Konfusionsmatrix:Eine Konfusionsmatrix gibt Aufschluss über die korrekten und inkorrekten Vorhersagen jeder Klasse.
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
Klassifizierungsbericht:Der Klassifizierungsbericht enthält Kennzahlen wie Präzision, Trefferquote und F1-Score für jede Klasse.
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Wichtigkeit der Merkmale:Das Verständnis dafür, welche Merkmale die Entscheidungen Ihres Modells am stärksten beeinflussen, kann wertvolle Einblicke in den Datensatz liefern.
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
Modellinterpretation
Der Genauigkeitswert, die Verwirrungsmatrix und der Klassifizierungsbericht bieten zusammen einen umfassenden Überblick über die Leistung des Modells. Die hohe Genauigkeit zeigt die Wirksamkeit des Modells bei der Klassifizierung von Irisarten an, während die Verwirrungsmatrix und der Klassifizierungsbericht seine Präzision, seinen Rückruf und seine f1-Werte für alle Klassen detailliert beschreiben.
Das Merkmalswichtigkeitsdiagramm zeigt, welche Eigenschaften der Irisblüten (wie Länge oder Breite der Blütenblätter) die Klassifizierungsentscheidungen des Modells beeinflussen. Diese Erkenntnisse sind wertvoll für das Verständnis des Entscheidungsprozesses des Random Forest-Modells und zukünftiger Feature-Engineering- oder Auswahlbemühungen.
Durch die Interpretation dieser Ergebnisse können wir den Schluss ziehen, dass der Random Forest-Klassifikator für diesen Datensatz äußerst effektiv ist und eine solide Grundlage für prädiktive Modellierungsaufgaben bietet. Das Experimentieren mit verschiedenen Datensätzen oder das Anpassen von Hyperparametern könnte die Leistung oder Anpassungsfähigkeit des Modells an verschiedene Probleme verbessern.
Interpretation einzelner Entscheidungsbäume im Random Forest
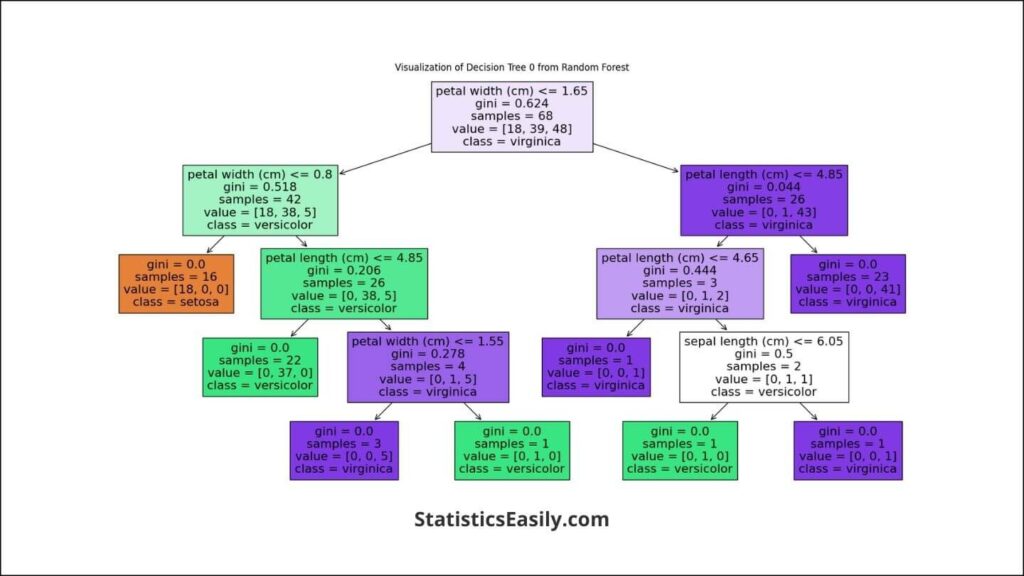
Während Random Forest eine Sammlung von Entscheidungsbäumen ist, trägt jeder Baum zum Ergebnis bei. Die Visualisierung einzelner Bäume kann Einblicke in den Entscheidungsprozess auf einer detaillierteren Ebene geben. Schauen wir uns einen solchen Baum aus unserem Random-Forest-Modell an:
Visualisierung eines Entscheidungsbaums aus dem Random Forest:
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
Diese Visualisierung zeigt, wie ein einzelner Entscheidungsbaum innerhalb des Random Forest Klassifizierungen vornimmt. Es beginnt oben mit einem Wurzelknoten, teilt sich dann basierend auf Merkmalswerten in Zweige und Entscheidungsknoten auf und endet schließlich mit Blattknoten, die die Klassenvorhersagen darstellen.
Analyse der Baumstruktur:
Jeder Knoten im Baum stellt eine Entscheidung dar, die auf dem Wert eines bestimmten Merkmals basiert. Beispielsweise könnte ein Knoten die Daten basierend auf der Länge oder Breite des Blütenblatts einer Iris aufteilen. Die Zweige stellen das Ergebnis dieser Entscheidung dar und führen zu neuen Entscheidungsknoten oder Blattknoten. Die Blattknoten liefern die endgültigen Klassenvorhersagen, wenn eine Reihe von Kriterien erfüllt ist, die durch den Pfad vom Stamm aus bestimmt werden.
Die Tiefe und Komplexität dieses Baums geben Aufschluss über die Klassifizierungsstrategie des Modells. In der Praxis kombiniert Random Forest die Vorhersagen mehrerer solcher Bäume, um eine endgültige, genauere Klassifizierung zu erstellen und so die Stärken jedes Baums zu nutzen und gleichzeitig seine Schwächen auszugleichen.
Das Einbinden einer Entscheidungsbaum-Visualisierung wie der oben generierten kann Ihren Artikel bereichern, indem es den Lesern ermöglicht, den Vorhersageprozess zu visualisieren. Es entmystifiziert die Funktionsweise des Modells und liefert ein konkretes Beispiel dafür, wie Random Forest mehrere Entscheidungspfade nutzt, um zu einer Klassifizierungsentscheidung zu gelangen.
Bewerten Sie Ihr Modell
Nach der Implementierung des Random Forest-Modells mit Python besteht der nächste entscheidende Schritt in der Bewertung seiner Leistung. Dazu gehört die Verwendung spezifischer Metriken, um zu verstehen, wie gut das Modell Ergebnisse anhand neuer, unsichtbarer Daten vorhersagt. Dieser Abschnitt behandelt die kritischen Bewertungsmetriken und bietet Tipps zur Modellverbesserung und -optimierung.
So bewerten Sie die Leistung Ihres Random-Forest-Modells:
Bewertungsmetriken sind wichtig, um die Genauigkeit und Wirksamkeit Ihres Random Forest-Modells zu bewerten. Hier sind die am häufigsten verwendeten Metriken:
Genauigkeit: Dies ist die einfachste Kennzahl und wird berechnet, indem die Anzahl der korrekten Vorhersagen durch die Gesamtzahl der Vorhersagen geteilt wird. Obwohl die Genauigkeit allein nützlich ist, kann sie irreführend sein, insbesondere bei Datensätzen mit ungleich verteilten Klassen.
Präzision und Rückruf: Präzision (der Anteil der richtig positiven Ergebnisse an allen positiven Vorhersagen) und Trefferquote (der Anteil der richtig positiven Ergebnisse an allen tatsächlichen positiven Ergebnissen) sind von entscheidender Bedeutung, wenn die Kosten falsch positiver und falsch negativer Ergebnisse hoch sind, beispielsweise in der medizinischen Diagnostik oder bei der Betrugserkennung.
F1-Score: Der F1-Score ist das harmonische Mittel aus Präzision und Trefferquote und bietet eine einzelne Kennzahl zur Beurteilung ihres Verhältnisses. Der beste Wert für einen F1-Score ist 1 (perfekte Präzision und Trefferquote), der schlechteste 0.
Konfusionsmatrix: Eine Tabelle zur Beschreibung der Leistung eines Klassifikationsmodells anhand eines Testdatensatzes, dessen wahre Werte bekannt sind. Sie ermöglicht die Visualisierung der Modellvorhersagen, einschließlich richtig positiver, falsch positiver, richtig negativer und falsch negativer Ergebnisse.
Interpretieren der Ergebnisse:
Wenn Sie diese Metriken verstehen, können Sie die Leistung des Modells genau einschätzen. Beispielsweise könnte eine hohe Genauigkeitsrate auf den ersten Blick hervorragend erscheinen. Eine weitere Untersuchung anhand von Präzision, Erinnerung und dem F1-Score könnte jedoch Bereiche aufdecken, in denen das Modell Probleme hat, beispielsweise wenn es nicht gelingt, eine bestimmte Klasse genau vorherzusagen.
Tipps zur Modellverbesserung und -abstimmung:
Hyperparameter-Tuning: Random-Forest-Modelle verfügen über mehrere Hyperparameter, wie die Anzahl der Bäume (n_estimators) und die Baumtiefe (max_depth), die die Leistung erheblich beeinflussen können. Mithilfe von Gittersuche oder Zufallssuche lässt sich die optimale Kombination dieser Hyperparameter für Ihren spezifischen Datensatz finden.
Merkmalsauswahl: Random Forests können die Wichtigkeit von Merkmalen inhärent einstufen. Durch die Analyse und Eliminierung weniger wichtiger Merkmale lässt sich die Komplexität des Modells reduzieren und die Leistung verbessern.
Kreuzvalidierung: Die Anwendung von Kreuzvalidierung, wie z. B. k-facher Kreuzvalidierung, trägt dazu bei, dass die Leistung Ihres Modells über verschiedene Teilmengen Ihres Datensatzes hinweg konsistent ist, wodurch die Robustheit Ihres Modells erhöht wird.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Fazit
Dieser Artikel bietet einen umfassenden Leitfaden zum Verständnis und zur Anwendung von Random Forest in Python und behandelt die theoretischen Grundlagen, die Datenvorbereitung, die praktische Implementierung und die Modellevaluierung. Mit seiner Fähigkeit, Klassifizierungs- und Regressionsaufgaben effektiv zu bewältigen, bleibt Random Forest ein leistungsstarkes Werkzeug im Arsenal des Datenwissenschaftlers und bietet hohe Genauigkeit und Robustheit gegen Überanpassung. Die Ermutigung, mit verschiedenen Datensätzen zu experimentieren und sich verschiedenen Problemen der Vorhersagemodellierung zu stellen, unterstreicht die Vielseitigkeit und Anpassungsfähigkeit von Random Forest. Durch das Befolgen der detaillierten Schritte, von der Einrichtung der Python-Umgebung bis zur Bewertung der Modellleistung, sind die Leser bestens gerüstet, um Random Forest in ihren Data-Science-Projekten zu nutzen und die Grenzen der prädiktiven Analyse zu erweitern.
Empfohlene Artikel
Weitere Einblicke und Tutorials zu Data Science-Themen finden Sie in unseren anderen Artikeln.
- Entscheidungsbäume: Von der Theorie zur Praxis in Python für angehende Datenwissenschaftler
- Zufallsstichproben verstehen: Grundlegende Techniken in der Datenanalyse
- Zufallsstichprobe in Excel: Eine eingehende Analyse
- Logistische Regression mit Scikit-Learn (Geschichte)
- Generieren Sie eine Zufallszahl
Häufig gestellte Fragen (FAQs)
Frage 1: Was ist Random Forest?Es handelt sich um eine vielseitige Methode des maschinellen Lernens, die Regressions- und Klassifizierungsaufgaben durchführen kann. Dabei werden mehrere Entscheidungsbäume verwendet und deren Vorhersagen gemittelt, um die Genauigkeit zu verbessern und Überanpassung zu kontrollieren.
Frage 2: Wie funktioniert ein Random Forest?Ein Random Forest erstellt einen „Wald“ aus zufälligen Entscheidungsbäumen, um durch Mittelung der Ergebnisse oder Mehrheitsentscheidung genauere Vorhersagen zu ermöglichen als ein einzelner Entscheidungsbaum.
Frage 3: Warum wird Random Forest anderen Algorithmen vorgezogen?Es wird aufgrund seiner Vielseitigkeit, seiner Fähigkeit, große Datensätze mit höherer Dimensionalität zu verarbeiten, und seiner Fähigkeit, fehlende Werte zu behandeln, bevorzugt, wodurch es robust gegenüber Überanpassung ist.
Frage 4: Was sind die Hauptanwendungen von Random Forest?Es wird in verschiedenen Bereichen wie Bankwesen, Medizin, Aktienmarkt und E-Commerce zur Betrugserkennung, Krankheitsvorhersage, Aktienkursvorhersage und Kundensegmentierung eingesetzt.
Frage 5: Wie bereitet man Daten für Random Forest vor?Die Datenaufbereitung umfasst die Bereinigung, den Umgang mit fehlenden Werten, die Kodierung kategorialer Variablen und die Aufteilung des Datensatzes in Trainings- und Testdatensätze.
Frage 6: Was sind Hyperparameter im Random Forest und wie beeinflussen sie das Modell?Hyperparameter beeinflussen die Komplexität und Leistung des Modells, beispielsweise die Anzahl der Bäume, die Baumtiefe und die minimale Anzahl an Stichproben für eine Aufteilung. Durch deren Optimierung lässt sich die Genauigkeit deutlich verbessern.
Frage 7: Wie lässt sich die Effektivität eines Random-Forest-Modells beurteilen?Zu den Standard-Bewertungsmetriken gehören Genauigkeit, Präzision, Trefferquote, F1-Score und die Konfusionsmatrix, die dabei helfen, die Vorhersageleistung und Genauigkeit des Modells zu beurteilen.
Frage 8: Welche Herausforderungen gibt es bei der Verwendung von Random Forests?Random Forests sind zwar leistungsstark, aber im Vergleich zu einfacheren Modellen rechenintensiv und schwer zu interpretieren, und ihre Leistung kann empfindlich auf verrauschte Daten reagieren.
Frage 9: Wie optimiert man ein Random-Forest-Modell für eine bessere Leistung?Die Modelloptimierung beinhaltet die Anpassung von Hyperparametern wie der Anzahl der Bäume, der maximalen Tiefe und der minimalen Stichprobenaufteilung mithilfe von Raster- oder Zufallssuchverfahren, um die optimalen Einstellungen zu finden.
Frage 10: Kann Random Forest sowohl kategoriale als auch numerische Daten verarbeiten?Ja, Random Forest kann sowohl kategoriale als auch numerische Daten verarbeiten. Es verwendet Techniken wie One-Hot-Encoding für kategoriale Variablen, um die Daten für die Modellierung geeignet zu machen.