Entscheidungsbäume: Von der Theorie zur Praxis in Python für angehende Datenwissenschaftler
Sie lernen die Grundprinzipien von Entscheidungsbäumen und deren praktische Anwendung in Python kennen, um datengesteuerte Erkenntnisse zu gewinnen.
Einführung
Entscheidungsbäumesind ein Eckpfeiler der Datenanalyse, Data Science und des maschinellen Lernens. Sie bieten ein Framework, das komplexe Entscheidungsprozesse durch seine intuitive Struktur vereinfacht. Diese Modelle zerlegen Daten in verständliche Segmente und ermöglichen es sowohl erfahrenen Experten als auch Einsteigern, Muster und Erkenntnisse klar zu erkennen. Die Eleganz vonEntscheidungsbäumeliegt in ihrer Fähigkeit, komplexe Datensätze in visuell verständliche und logisch organisierte Informationen umzuwandeln und so fundierte Entscheidungen und Prognosen zu ermöglichen. Diese Einführung legt den Grundstein für die Nutzung vonEntscheidungsbäume in Pythonund führt angehende Data Scientists vom theoretischen Verständnis zur praktischen Anwendung.
Highlights
- Entscheidungsbäume klassifizieren Daten mit beispielloser Einfachheit und Genauigkeit.
- Scikit-learn von Python macht die Implementierung von Entscheidungsbäumen unkompliziert.
- Entscheidungsbäume beleuchten komplexe Daten und bieten klare Wege zur Entscheidungsfindung.
- Optimierungstechniken verbessern die Präzision von Entscheidungsbäumen ohne Überanpassung.
- Die Visualisierung von Entscheidungsbäumen in Python entmystifiziert Datenanalyseprozesse.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Entscheidungsbäume verstehen
Entscheidungsbäumesind eine Methode der Datenanalyse, die eine hierarchische Struktur von Entscheidungen und deren möglichen Konsequenzen darstellt, einschließlich Zufallsereignissen, Ressourcenkosten und Nutzen. Diese Methode ist in der Datenwissenschaft aufgrund ihrer Klarheit bei der Entscheidungsfindung und ihrer Interpretierbarkeit sehr beliebt.
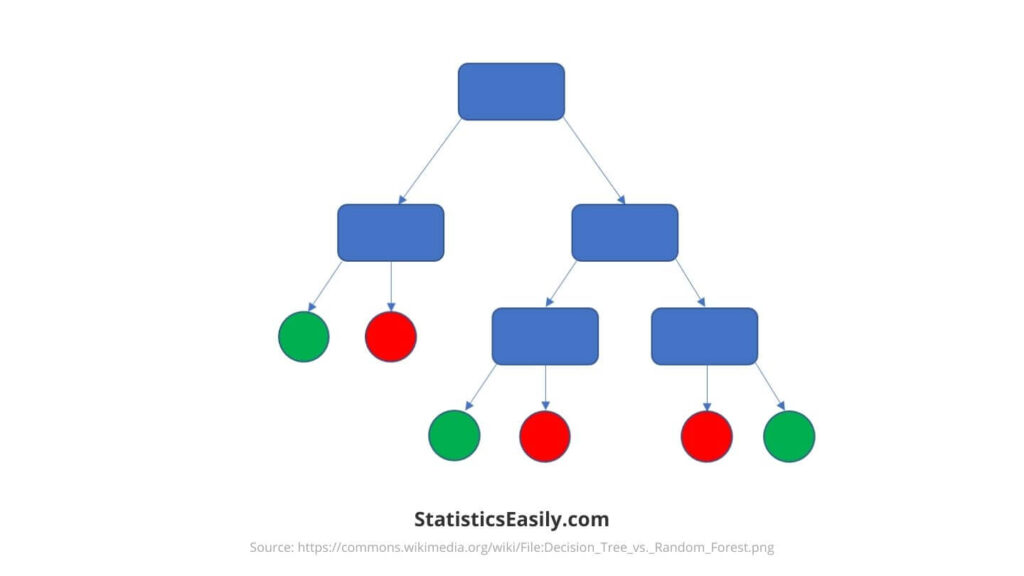
Im Kern teilenEntscheidungsbäumeDaten anhand von Entscheidungskriterien, die sich aus den Merkmalen des Datensatzes ergeben, in Zweige auf. Diese Aufteilung erfolgt an den Knoten, wobei der erste Knoten die Wurzel des Baums darstellt. Jeder Knoten repräsentiert einen Entscheidungspunkt, und die Zweige repräsentieren das Ergebnis dieser Entscheidung, was zu weiteren Aufteilungen führt, bis die Blattknoten die Ergebnisse oder Vorhersagen darstellen.
Die Erstellung einesEntscheidungsbaumerfordert die Bestimmung des optimalen Merkmals für die Aufteilung in jedem Schritt. Diese Entscheidung basiert auf Kennzahlen wie dem Gini-Koeffizienten oder der Entropie bei Klassifizierungsaufgaben und der Varianzreduktion bei Regressionsaufgaben. Diese Kriterien helfen dabei, die Aufteilungen auszuwählen, die die Kindknoten am effektivsten bereinigen.
Die Tiefe einesEntscheidungsbaummisst den längsten Pfad von der Wurzel zu einem Blatt. Ein tieferer Baum kann die Trainingsdaten zwar genauer modellieren, birgt aber auch das Risiko der Überanpassung – das Modell schneidet dann bei den Trainingsdaten gut ab, jedoch schlecht bei unbekannten Daten. Umgekehrt kann ein flacher Baum zu einfach sein, um die zugrundeliegende Struktur der Daten zu erfassen, was zu Unteranpassung führt.
Entscheidungsbäumesind aufgrund ihrer Fähigkeit, komplexe Entscheidungsprozesse durch eine Kombination aus Einfachheit und Robustheit zu modellieren, sehr beliebt. Sie können sowohl numerische als auch kategoriale Daten verarbeiten und sind daher vielseitig für ein breites Anwendungsspektrum geeignet. Darüber hinaus ermöglicht ihre Struktur eine einfache Visualisierung und Interpretation und macht sie so zu einem zugänglichen Werkzeug für Datenwissenschaftler, um ihre Ergebnisse zu kommunizieren.
Die theoretische Grundlage vonEntscheidungsbäumebetont die technische Umsetzung und die übersichtliche Darstellung datenbasierter Entscheidungen. Dies entspricht dem Streben nach Wahrheit und Erkenntnis in der Datenwissenschaft und veranschaulicht, wie Daten analysiert werden können, um Erkenntnisse zu gewinnen, die fundierte und handlungsrelevante Entscheidungen ermöglichen. Mithilfe dieser Methode können Datenwissenschaftler die Komplexität ihrer Datensätze bewältigen, Muster erkennen und Ergebnisse präzise und gleichzeitig einfach vorhersagen.
Die Bedeutung von Entscheidungsbäumen in der Datenanalyse
Die Anwendung vonEntscheidungsbäumereicht weit über einen einzelnen Bereich hinaus und beweist ihre beispiellose Vielseitigkeit in verschiedenen Feldern, darunter Business Analytics, Gesundheitswesen, Finanzen und mehr. In der Unternehmensentscheidung dienen sie beispielsweise der Bewertung potenzieller Ergebnisse strategischer Entscheidungen, der Risikoanalyse und der Kundensegmentierung. Fachkräfte im Gesundheitswesen nutzenEntscheidungsbäumezur Diagnosevorhersage, zur Risikobewertung von Patienten und zur Analyse der Behandlungseffektivität. Sie bieten damit einen Weg zu personalisierter Medizin und verbesserter Patientenversorgung.
Ein entscheidender Vorteil vonEntscheidungsbäumeist ihre Interpretierbarkeit. Im Gegensatz zu vielen komplexen Modellen, die als „Black Boxes“ fungieren, visualisierenEntscheidungsbäumeden Entscheidungsprozess und ermöglichen es den Nutzern, die Schlussfolgerungen nachzuvollziehen. Diese Transparenz ist in Bereichen, in denen das Verständnis der Begründung einer Vorhersage ebenso wichtig ist wie die Vorhersage selbst – beispielsweise im Gesundheitswesen und im Finanzwesen – von unschätzbarem Wert.
Darüber hinaus ist die einfache Anwendbarkeit vonEntscheidungsbäumebemerkenswert. Sie erfordern keine aufwendige Datenaufbereitung; kategoriale und numerische Daten können direkt verarbeitet werden, und nichtlineare Beziehungen zwischen Parametern beeinträchtigen ihre Leistung nicht. Diese Benutzerfreundlichkeit gewährleistet, dassEntscheidungsbäumeeinem breiten Publikum zugänglich bleiben, auch solchen mit geringen Statistik- oder Programmierkenntnissen.
Die Stärke vonEntscheidungsbäumeim analytischen Bereich liegt in ihrer Fähigkeit, Einfachheit mit hoher Vorhersagekraft zu verbinden. Sie lassen sich auf Regressions- und Klassifizierungsprobleme anwenden und sind somit ein vielseitiges Werkzeug im Repertoire von Data Scientists. Darüber hinaus ermöglicht ihre Struktur die einfache Anwendung von Techniken wie dem Pruning, wodurch Überanpassung vermieden und die Robustheit und Zuverlässigkeit des Modells sichergestellt wird.
Vorbereiten Ihrer Daten für ein Entscheidungsbaummodell
Die Datenaufbereitung ist ein entscheidender Schritt bei der Modellierung, insbesondere bei der Arbeit mitEntscheidungsbäume. Dieser Abschnitt beschreibt die wichtigsten Schritte zur Vorbereitung Ihres Datensatzes: die Bereinigung und Aufteilung in Trainings- und Testdatensätze. Jeder Schritt gewährleistet die Integrität Ihres Modells und spiegelt das strenge Streben nach Genauigkeit in der Datenwissenschaft wider.
Die Datenbereinigungumfasst das Identifizieren und Korrigieren von Fehlern oder Inkonsistenzen in Ihrem Datensatz. Dies kann das Bearbeiten fehlender Werte, das Entfernen von Duplikaten oder das Korrigieren von Dateneingabefehlern beinhalten. FürEntscheidungsbäumeist die Gewährleistung fehlerfreier Daten von entscheidender Bedeutung, da diese Modelle die Datenstruktur und den Inhalt direkt interpretieren. Saubere Daten bilden die Grundlage für vertrauenswürdige und interpretierbare Modelle.
Die Aufteilung Ihrer Datenin Trainings- und Testdatensätze ist ein entscheidender Schritt zur Bewertung der Effektivität IhresEntscheidungsbaum. Die Daten werden üblicherweise zufällig aufgeteilt, wobei standardmäßig 70 % für das Training und 30 % für den Test verwendet werden. Der Trainingsdatensatz dient dem Aufbau des Modells, während der Testdatensatz dessen Leistung anhand unbekannter Daten überprüft. Dieser Schritt ist entscheidend für die Beurteilung der Generalisierbarkeit des Modells und stellt sicher, dass es präzise Vorhersagen für neue, unbekannte Daten treffen kann. Er ist die Grundlage für die Erstellung von Modellen, die die Realität widerspiegeln und auf die man sich bei Entscheidungen verlassen kann.
Erstellen Sie Ihre ersten Entscheidungsbäume in Python
Das Erstellen einesEntscheidungsbaumin Python vereinfacht die Datenanalyse und das maschinelle Lernen und macht sie auch für Anfänger zugänglich. Dieser Abschnitt führt Sie durch die Erstellung Ihres erstenEntscheidungsbaummit Python und legt dabei Wert auf praktische Erfahrung und Verständlichkeit.
Einrichten Ihrer Python-Umgebung
1. Stellen Sie sicher, dass Python auf Ihrem Computer installiert ist. Sie können es vonpython.org.
2. Installieren Sie die erforderlichen Bibliotheken mit pip, dem Paketinstallationsprogramm von Python. Öffnen Sie Ihr Terminal oder Ihre Eingabeaufforderung und führen Sie Folgendes aus:
pip install numpy pandas scikit-learn matplotlib
Diese Befehle installieren NumPy und Pandas für die Datenbearbeitung, Scikit-Learn für maschinelles Lernen und Matplotlib für die Visualisierung.
Laden und Vorbereiten Ihres Datensatzes
1. Importieren Sie die Bibliotheken und laden Sie Ihren Datensatz. Für dieses Tutorial verwenden wir den Iris-Datensatz, einen einfachen, aber aufschlussreichen Datensatz, der direkt in scikit-learn verfügbar ist.
from sklearn.datasets import load_iris
import pandas as pd

iris = load_iris()
data = pd.DataFrame(data=iris.data, columns=iris.feature_names)
data['target'] = iris.target
2. Bereinigen Sie Ihren Datensatz, indem Sie nach fehlenden Werten oder Ausreißern suchen und diese behandeln. Der Iris-Datensatz ist bereits sauber, sodass hier keine weiteren Maßnahmen erforderlich sind.
3. Teilen Sie Ihren Datensatz in Trainings- und Testsätze auf, um die Leistung Ihres Modells genau zu bewerten.
from sklearn.model_selection import train_test_split

X = data.drop('target', axis=1)
y = data['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
Implementierung eines Entscheidungsbaummodells mit Scikit-learn
1. Importieren Sie den DecisionTreeClassifier aus scikit-learn und erstellen Sie eine Instanz des Klassifikators.
from sklearn.tree import DecisionTreeClassifier

dtree = DecisionTreeClassifier(random_state=42)
2. Passen Sie das Modell an Ihre Trainingsdaten an.
dtree.fit(X_train, y_train)
Visualisierung des Entscheidungsbaums
1. Visualisieren Sie den trainiertenEntscheidungsbaum, um zu verstehen, wie er Entscheidungen trifft.
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt

plt.figure(figsize=(20,10))
plot_tree(dtree, filled=True, feature_names=iris.feature_names, class_names=iris.target_names)
plt.show()
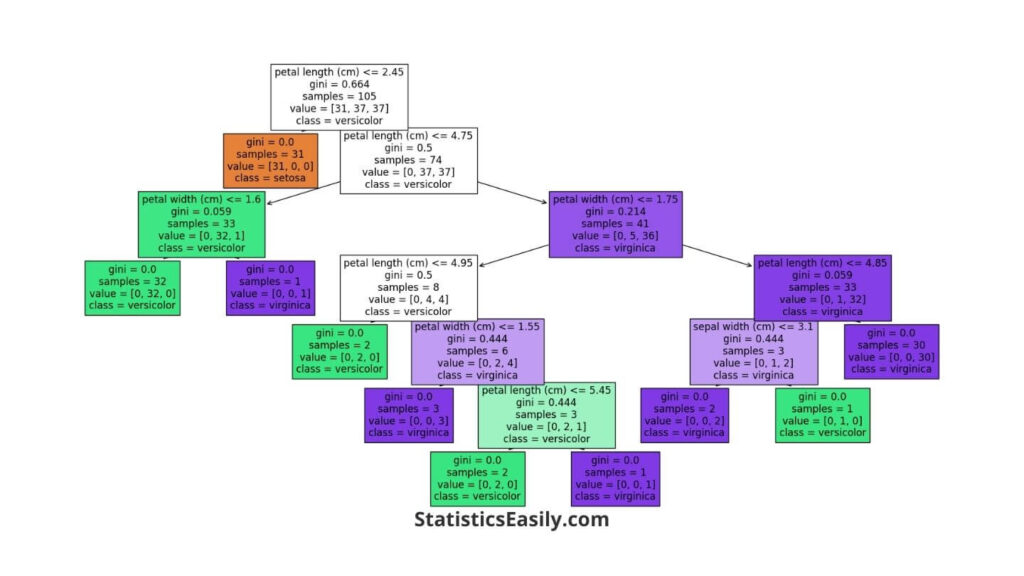
Dieses Bild stellt ein Entscheidungsbaummodell dar, das darauf trainiert wurde, Irisblüten in eine von drei Arten zu klassifizieren. Es basiert auf dem Iris-Datensatz, der Messungen wie Blütenblattlänge und -breite umfasst. Hier ist eine Aufschlüsselung dessen, was wir in diesem Entscheidungsbaum sehen:
- Knoten (Rechtecke):Jedes Rechteck ist ein Knoten, der eine Entscheidung trifft. Der Baum beginnt mit dem Wurzelknoten oben und endet mit dem Blattknoten. Die Knoten testen die Daten anhand bestimmter Kriterien, beispielsweise ob die Blütenblattlänge einen bestimmten Wert unterschreitet.
- Zweige (Linien, die Knoten verbinden):Diese Linien leiten den Weg von einer Entscheidung zur nächsten, basierend auf den von den Knoten festgelegten Kriterien.
- Blattknoten (Endrechtecke):Die letzten Knoten (Blätter) geben uns die vorhergesagte Klasse (Art der Irisblume). Sie teilen sich nicht weiter auf, da sie die fundierteste Vorhersage darstellen, die das Modell mit den gegebenen Daten treffen kann.
- Gini (Metrik in Knoten):Der Gini-Score misst die Reinheit – 0 bedeutet völlige Reinheit (alle Proben in einem Knoten gehören zur gleichen Klasse), und höhere Scores weisen auf eine Mischung von Klassen innerhalb eines Knotens hin.
- Beispiele (in Knoten):Dies sagt uns, wie viele Beispiele aus den Daten an dieser Stelle im Baum berücksichtigt werden.
- Wert (in Knoten):Dieses Array zeigt die Verteilung der Klassen in den Stichproben an diesem Knoten. Beispielsweise bedeutet [0, 34, 2] 0 Setosas, 34 Versicolors und 2 Virginicas.
- Klasse (in Knoten):Dies ist die Vorhersage des Modells an diesem Knoten. Der Entscheidungsbaum kennzeichnet jeden Datenpunkt in diesem Knoten mit dieser Klasse.
Wenn wir uns diesen Entscheidungsbaum ansehen, können wir den Entscheidungspfad von oben nach unten verfolgen. Angenommen, wir haben eine Irisblüte mit einer Blütenblattlänge von weniger als 2.45 cm. In diesem Fall klassifiziert der Entscheidungsbaum es als Setosa (wie im Blattknoten ganz links zu sehen ist). Der Baum bietet eine transparente Möglichkeit, genau zu sehen, wie das Modell auf der Grundlage der Eingabemerkmale zu einer Schlussfolgerung kommt.
Praktisches Beispiel
Die Verwendung des Iris-Datensatzes ermöglicht es Ihnen, die Nuancen vonEntscheidungsbäumeerkunden, ohne von komplexen Daten überfordert zu werden. Dank seiner Einfachheit und Praxisrelevanz gewährleistet dieser Datensatz Klarheit und regt zum Nachdenken an – so lernen Sie die Grundlagen vonEntscheidungsbäume in Python.
Sie haben Ihren erstenEntscheidungsbaumerstellt und visualisiert , indem Sie diese Schritte befolgt haben. Dieser Prozess – von der Einrichtung Ihrer Umgebung bis zur Analyse eines einfachen Datensatzes – demonstriert die Leistungsfähigkeit und Zugänglichkeit von maschinellem Lernen in Python.Entscheidungsbäumebieten eine robuste und nachvollziehbare Methode für Data Scientists aller Erfahrungsstufen, sei es für prädiktive Analysen, Datenexploration oder die Gewinnung von Erkenntnissen aus komplexen Datensätzen.
Bewerten und Optimieren Ihres Entscheidungsbaummodells
Nachdem Sie Ihr Entscheidungsbaummodell in Python erstellt haben, sind die nächsten wichtigen Schritte die Bewertung und Optimierung. Diese Prozesse stellen sicher, dass Ihr Modell effektiv funktioniert und genaue Vorhersagen trifft.
Bewerten Sie Ihr Entscheidungsbaummodell
Die Leistung Ihres Entscheidungsbaummodells kann anhand von Metriken wie Genauigkeit, Präzision und Erinnerung bewertet werden. Genauigkeit misst den Anteil korrekter Vorhersagen, Präzision spiegelt die Fähigkeit des Modells wider, nur relevante Instanzen zu identifizieren, und Rückruf gibt die Fähigkeit des Modells an, alle relevanten Fälle innerhalb des Datensatzes zu finden.
from sklearn.metrics import accuracy_score, precision_score, recall_score

predictions = dtree.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, predictions)}")
print(f"Precision: {precision_score(y_test, predictions, average='macro')}")
print(f"Recall: {recall_score(y_test, predictions, average='macro')}")
Techniken zur Optimierung von Entscheidungsbäumen
Die Optimierung Ihres Entscheidungsbaums umfasst die Anpassung von Parametern, um die Leistung zu verbessern und eine Überanpassung zu verhindern. Zu den wichtigsten Techniken gehören:
Beschneiden: Die Baumgröße wird reduziert, um Abschnitte mit geringer Aussagekraft für die Klassifizierung von Instanzen zu entfernen. Das Beschneiden kann durch Parameter wie `max_depth`, der die Tiefe des Baums begrenzt, und `min_samples_split`, der die Mindestanzahl an Stichproben angibt, die zum Aufteilen eines internen Knotens erforderlich sind, erreicht werden.
dtree_optimized = DecisionTreeClassifier(max_depth=3, min_samples_split=5, random_state=42)
dtree_optimized.fit(X_train, y_train)
Maximale Tiefe: Durch die Begrenzung der Baumtiefe wird verhindert, dass das Modell zu komplex wird und die Trainingsdaten überangepasst werden.
Min Samples Split: Durch die Festlegung einer Mindestanzahl von Stichproben, die für die Aufteilung eines Knotens erforderlich sind, wird das Modell allgemeiner und die Wahrscheinlichkeit, dass Rauschen im Trainingsdatensatz angepasst wird, verringert sich.
Ethische Überlegungen bei der Modelloptimierung
Die Optimierung eines Modells geht über bloße technische Anpassungen hinaus; Dabei geht es um ethische Überlegungen, insbesondere darum, sicherzustellen, dass die Vorhersagen des Modells fair sind und keine Verzerrungen aufrechterhalten. Eine Überanpassung beeinträchtigt die Genauigkeit des Modells bei unsichtbaren Daten. Dies kann zu Entscheidungen führen, die möglicherweise nicht die wahre Natur der Daten oder der Realität widerspiegeln. Es ist von entscheidender Bedeutung, die Komplexität des Modells mit seiner Interpretierbarkeit und Fairness in Einklang zu bringen und sicherzustellen, dass die vom Modell getroffenen Entscheidungen gerechtfertigt und ethisch sind.
Die Sicherstellung, dass Modelle die Realität genau widerspiegeln, unterstreicht unser Engagement für die Wahrheit. Es erfordert strenge Tests verschiedener Datensätze, um Verzerrungen zu erkennen und zu mildern. Datenwissenschaftler haben die ethische Verantwortung, dafür zu sorgen, dass ihre Modelle dem Guten dienen und Schäden vermeiden, die durch ungenaue Vorhersagen entstehen könnten.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Fazit
Die Auseinandersetzung mit den komplexen Mechanismen vonEntscheidungsbäumehat deren tiefgreifendes Potenzial offenbart, Data Science zugänglich und wirkungsvoll zu gestalten. Durch die Kombination von Einfachheit und Tiefe bietenEntscheidungsbäumeeine Perspektive auf komplexe Datensätze und erleichtern so fundierte Entscheidungen. Diese Erkundung – von theoretischen Konzepten bis hin zur praktischen Anwendung in Python – unterstreicht die Vielseitigkeit und Leistungsfähigkeit vonEntscheidungsbäumeund beweist eindrucksvoll die Faszination der Data Science selbst.
Empfohlene Artikel
Entdecken Sie in unserem Blog weitere innovative Techniken und Einblicke in die Datenwissenschaft. Tauchen Sie tiefer in Entscheidungsbäume und darüber hinaus ein, um ein umfassendes Verständnis und eine praktische Anwendung in Ihren Projekten zu erhalten. Jetzt entdecken!
- Deskriptive Statistik und Inferenzstatistik: Vereinfachung der Datenanalyse
- Verallgemeinerte lineare Modelle in Python: Ein umfassender Leitfaden
- Lineare Regression mit Scikit-Learn: Ein umfassender Leitfaden
- P-Hacking: Eine versteckte Bedrohung für eine zuverlässige Datenanalyse
- Logistische Regression mit Scikit-Learn (Geschichte)
- Die 5 besten kostenlosen Tools zur Datenanalyse im Jahr 2024
Häufig gestellte Fragen (FAQs)
Frage 1: Was sind Entscheidungsbäume?Entscheidungsbäume sind nichtlineare Vorhersagemodelle, die in der Datenwissenschaft für Klassifizierungs- und Regressionsaufgaben eingesetzt werden.
Frage 2: Warum sind Entscheidungsbäume in der Datenanalyse wichtig?Sie bieten intuitive und klare Einblicke in komplexe Datensätze und sind daher für fundierte Entscheidungsprozesse unerlässlich.
Frage 3: Wie funktionieren Entscheidungsbäume in Python?Pythons Bibliotheken, wie scikit-learn, ermöglichen die einfache Implementierung und Visualisierung von Entscheidungsbäumen.
Frage 4: Können Entscheidungsbäume sowohl für Klassifizierung als auch für Regression verwendet werden?Ja, Entscheidungsbäume können beide Aufgabentypen effizient bewältigen und sind daher vielseitige Werkzeuge in der Datenwissenschaft.
Frage 5: Was macht Entscheidungsbäume so wertvoll?Ihre Einfachheit und Interpretierbarkeit, ohne dabei an Genauigkeit einzubüßen, machen sie für Analysten und Wissenschaftler unschätzbar wertvoll.
Frage 6: Wie bewerte ich die Leistung eines Entscheidungsbaums?Mithilfe von Kennzahlen wie Genauigkeit, Präzision und Trefferquote sowie visuellen Inspektionen des Baums selbst.
Frage 7: Was sind die größten Herausforderungen bei Entscheidungsbäumen?Überanpassung kann problematisch sein und erfordert Techniken wie das Beschneiden, um die Komplexität des Baums zu bewältigen.
Frage 8: Wie gehen Entscheidungsbäume mit kategorischen und numerischen Daten um?Sie können beide Datentypen grundsätzlich verarbeiten und teilen die Knoten anhand des Datentyps auf, um Entscheidungen zu optimieren.
Frage 9: Was versteht man unter Beschneidung bei Entscheidungsbäumen?Die Beschneidung reduziert die Größe von Entscheidungsbäumen, indem Abschnitte des Baums entfernt werden, die nur wenig Aussagekraft für die Klassifizierung von Instanzen besitzen.
Frage 10: Wie lassen sich Entscheidungsbäume in Python visualisieren?Mithilfe von Bibliotheken wie matplotlib und Graphviz können Entscheidungsbäume visuell dargestellt und so leichter interpretiert werden.