Normalverteilung verstehen: Ein umfassender Leitfaden
Eine Normalverteilung ist eine statistische Wahrscheinlichkeitsverteilung, die durch eine symmetrische glockenförmige Kurve gekennzeichnet ist, deren Mittelpunkt um den Mittelwert liegt. Seine Bedeutung liegt in der genauen Darstellung realer Daten und der Ermöglichung prädiktiver Analysen aufgrund seiner Vorhersagbarkeit und mathematischen Eigenschaften.
Die Definition der Normalverteilung
The Normalverteilungist ein statistisches Konzept, das die Verteilung von Daten über einen bestimmten Bereich beschreibt. Auch alsGaußsche VerteilungoderGlockenkurvebekannt , stellt die Normalverteilung Daten so dar, dass die meisten Werte in der Nähe des Mittelwerts der Verteilung liegen.
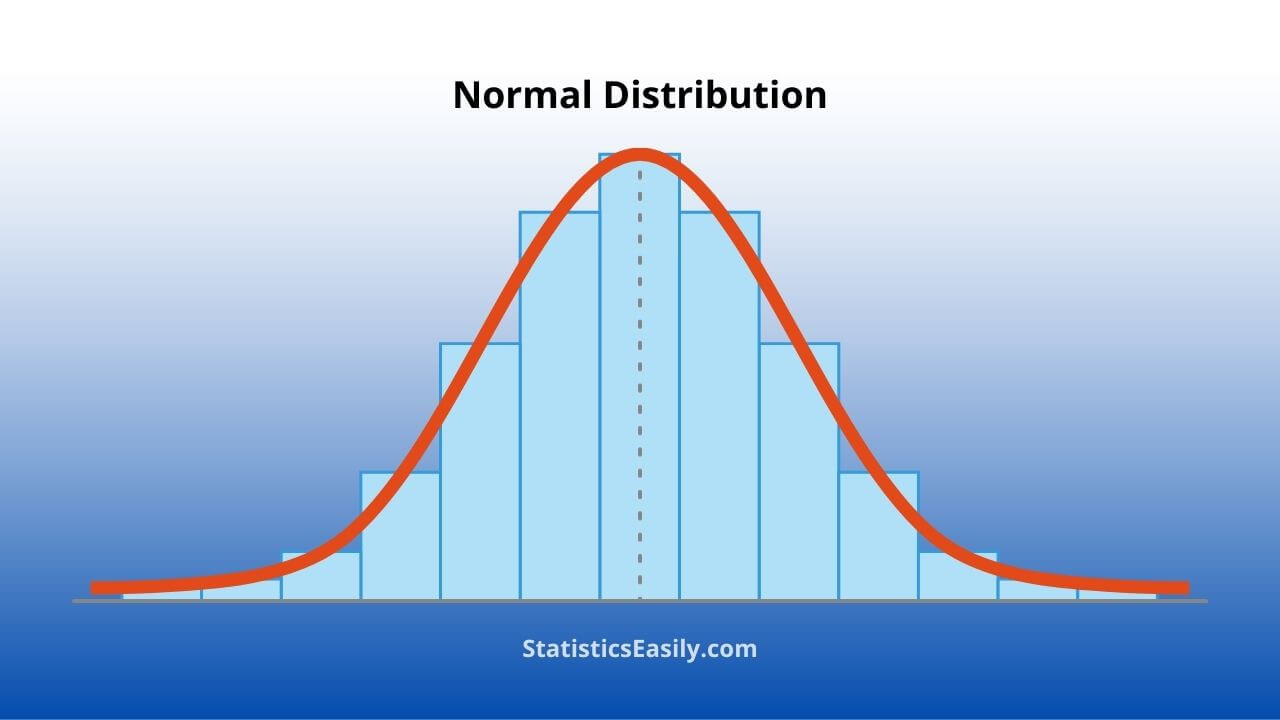
Die Normalverteilung ist symmetrisch, was bedeutet, dass die Wahrscheinlichkeit, dass Daten auf der einen Seite des Durchschnitts liegen, ebenso groß ist wie auf der anderen. Es zeichnet sich durch seine glockenartige Form aus, daher die Bezeichnung Glockenkurve. Diese Form resultiert daraus, dass sich die meisten Beobachtungen im Mittel häufen und die Häufigkeit allmählich abnimmt, wenn man sich vom Zentrum entfernt.
In der Praxis weist eine Normalverteilung eine hohe Häufigkeit von Daten in der Mitte (Mittelwert) auf, die auf beiden Seiten schwächer wird. Dieses Muster bildet die charakteristische Glockenform und bietet eine praktische Möglichkeit, einen Datensatz schnell zu verstehen.
Highlights
- Die Normalverteilung beschreibt die Datenverteilung um einen zentralen Mittelwert.
- Es wird oft als symmetrische, glockenförmige Kurve dargestellt.
- Mittelwert, Modus und Median haben in einer Normalverteilung den gleichen Wert.
- Ein QQ-Diagramm kann dabei helfen, die Normalverteilung zu identifizieren.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Die 5 Eigenschaften einer Normalverteilung
The Normalverteilungist durch fünf Haupteigenschaften definiert:
Symmetrie: Die Glockenkurve ist symmetrisch um den Mittelwert, was bedeutet, dass die Daten auf beiden Seiten des Zentrums gleichmäßig verteilt sind.
Mittelwert = Modus = Median: In einer Normalverteilung sind Mittelwert, Modus und Median alle gleich und liegen in der Mitte der Verteilung.
Asymptotisch:Die Enden der Normalverteilungskurve erstrecken sich unendlich weit, ohne die x-Achse zu erreichen. Dies deutet darauf hin, dass unabhängig von der Entfernung vom Mittelwert immer die Möglichkeit besteht, dass ein Datenpunkt existiert, wenn auch eine immer geringere.
Glockenförmig: Die Normalverteilungskurve hat eine Glockenform, wobei der höchste Punkt über dem Mittelwert liegt.
Abhängigkeit von Mittelwert und Standardabweichung: Die Form der Normalverteilung wird durch den Mittelwert (μ) und die Standardabweichung (σ) bestimmt.
So identifizieren Sie die Normalverteilung in Daten
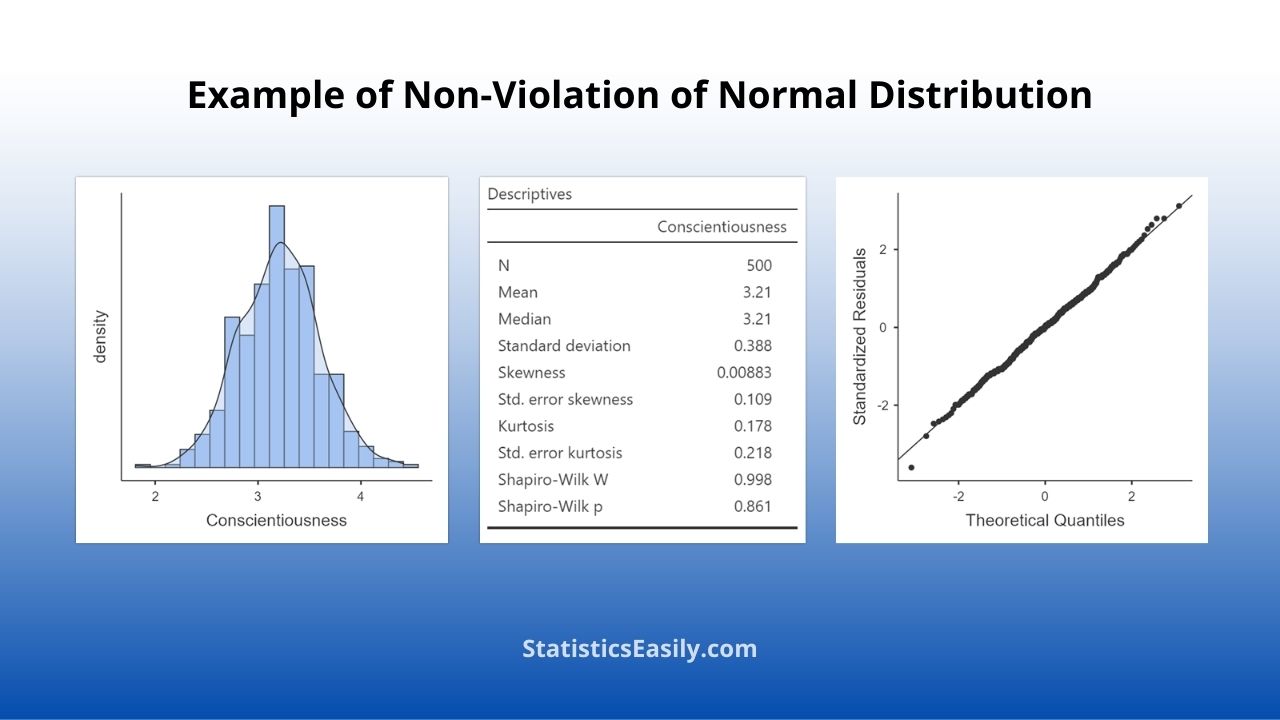
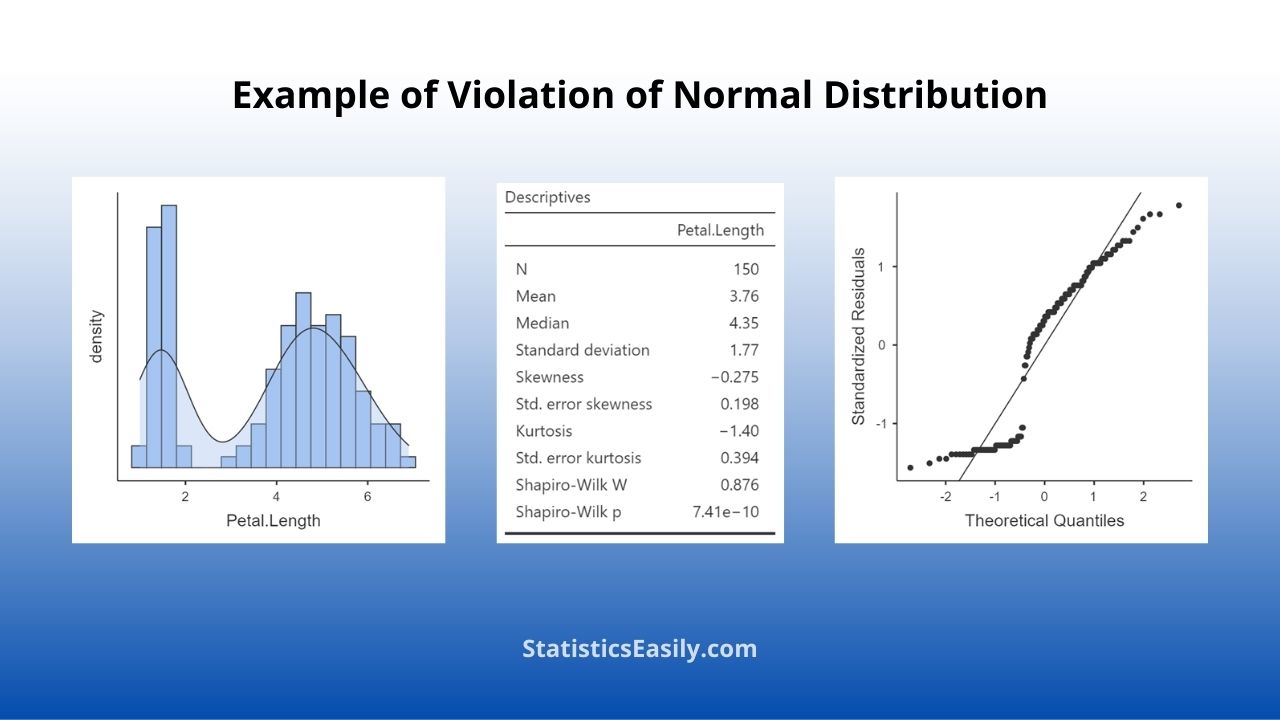
Identifizierung einesNormalverteilungin Daten erfordert sowohl eine visuelle Prüfung als auch eine statistische Analyse. Die visuelle Prüfung beinhaltet die Erstellung eines Datenhistogramms, bei dem nach der charakteristischen Glockenkurve gesucht wird, die die Normalverteilung kennzeichnet.
Neben der visuellen Überprüfung der Daten gibt es zusammenfassende Statistiken, die bei der Identifizierung der Normalverteilung hilfreich sein können. Diese statistischen Maße werden als zusammenfassende Statistiken bezeichnet.
Mittelwert, Median und Modus: Diese drei Maße der zentralen Tendenz sollten in einer Normalverteilung annähernd gleich sein.
Schiefe: Dieses Maß für die Asymmetrie der Wahrscheinlichkeitsverteilung sollte bei einer Normalverteilung nahe bei 0 liegen.
Kurtosis: Dieses Maß für die „Ausprägung der Ränder“ der Wahrscheinlichkeitsverteilung sollte bei einer Normalverteilung nahe bei 0 liegen, was auf eine ähnliche Ausprägung der Ränder wie bei der Normalverteilung hinweist.
Variationskoeffizient (CV): Dieses standardisierte Streuungsmaß sollte bei normalverteilten Daten eine geringe Variabilität (bis zu 30 %) aufweisen.
Wir haben Tests wie den Shapiro-Wilk-Test auf der fortgeschritteneren Seite der statistischen Tests. Dieser Test überprüft die Nullhypothese, dass eine Stichprobe aus einer normalverteilten Grundgesamtheit stammt. Beachten Sie, dass diese Tests empfindlich auf die Stichprobengröße reagieren und möglicherweise nicht immer zuverlässig sind.
Schließlich kann das normale Wahrscheinlichkeitsdiagramm, auch QQ-Diagramm genannt, zur Identifizierung der Normalverteilung verwendet werden. In diesem Diagramm werden die beobachteten Werte im Vergleich zu den bei einer Normalverteilung erwarteten Werten grafisch dargestellt. Die Daten sind normalverteilt, wenn die Punkte auf einer normalen Geraden liegen.
Die Bedeutung der Normalverteilung in der Statistik
The Normalverteilungspielt in der Statistik und den Naturwissenschaften eine entscheidende Rolle, da sie verschiedene natürlich auftretende Phänomene präzise beschreibt. In den Sozialwissenschaften wird sie häufig verwendet, um Zufallsvariablen in Populationen darzustellen.
Darüber hinaus ist die Normalverteilung ein wesentlicher Bestandteil des Hypothesentests, einer Schlüsselkomponente der statistischen Analyse. Der Zentrale Grenzwertsatz ist ein entscheidendes Prinzip auf dem Gebiet der Statistik. Es erklärt, dass viele unabhängige und identisch verteilte Zufallsvariablen, wenn sie addiert werden, dazu neigen, einer Normalverteilung zu folgen.
Beispiele aus der Praxis der Normalverteilung
The Normalverteilungtritt häufig in der realen Welt auf. Beispielsweise folgen Größenmaße wie Körpergröße, Gewicht und Länge in einer großen Population oft einer Normalverteilung. Weitere gängige Beispiele sind Blutdruck, Testergebnisse und Messfehler.
Die Normalverteilung ist für die Qualitätskontrolle und das Risikomanagement in der Geschäftswelt von entscheidender Bedeutung. Beispielsweise verwenden Unternehmen häufig die Normalverteilung, um zukünftige Verkäufe, Lagerbestände und Produktretouren vorherzusagen.
Herausforderungen: Warum Daten möglicherweise nicht immer normal verteilt sind
Daten folgen nicht immer einerNormalverteilung. Gründe hierfür können zugrunde liegende Zusammenhänge zwischen Variablen, eine Schiefe der Daten oder das Vorhandensein von Ausreißer.
Beispielsweise sind Einkommensdaten häufig nicht normalverteilt, da sie eine untere Nullgrenze haben, in der Regel positiv verzerrt sind und einen langen Schwanz nach rechts aufweisen und extreme Werte oder Ausreißer enthalten können.
Datentransformationen oder nichtparametrische statistische Methoden ermöglichen oft eine statistische Analyse in solchen Situationen.
Anzeigentitel
Werbebeschreibung. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Empfohlene Artikel
Nutzen Sie unsere anderen Artikel zu verwandten Themen! Erfahren Sie mehr über das Gebiet der Datenwissenschaft, indem Sie sich unseren Blog ansehen.
- Verallgemeinerte lineare Modelle (Geschichte)
- Welchen Normalitätstest sollten Sie verwenden?
- So berechnen Sie den Median in Excel – einfache Schritte
- Maße der zentralen Tendenz: Mittelwert, Modus, Median
- Standardnormalverteilung – ein Überblick (Externer Link)
- Kaplan-Meier-Überlebensanalyse in R: Beherrschung von Time-to-Event-Daten
- Leitfaden zur Verteilung und Auswahl von Linkfunktionen für das verallgemeinerte lineare Modell (GLM).
Häufig gestellte Fragen (FAQ)
Es handelt sich um ein Muster, bei dem die Daten symmetrisch um den Mittelwert verteilt sind und eine glockenförmige Kurve bilden.
Zu den Eigenschaften gehören Symmetrie, gleicher Mittelwert, Median, Modus und asymptotische Natur.
Untersuchen eines Histogramms und Durchführen statistischer Tests wie des Shapiro-Wilk-Tests oder Analysieren eines QQ-Diagramms.
Ja, in der Statistik handelt es sich um austauschbare Begriffe.
In der Statistik ist es von entscheidender Bedeutung, um reale Phänomene vorherzusagen und beim Testen von Hypothesen zu helfen.
Beispiele hierfür sind Größe, Gewicht und Testergebnisse in großen Populationen.
Ja, es ist wie ein Behälter mit der höchsten Frequenz in der Mitte, dessen Frequenzen zu den Enden hin gleichmäßig schwächer werden.
Aufgrund von Schiefe, Ausreißern oder zugrunde liegenden Beziehungen zwischen Variablen sind die Daten möglicherweise nicht immer normal.
Shapiro-Wilk- und Anderson-Darling-Tests sind standardmäßige statistische Methoden zur Überprüfung, ob ein Datensatz normalverteilt ist.
Wenn Daten nicht normalverteilt sind, verstoßen sie möglicherweise gegen die Annahmen bestimmter statistischer Tests, die möglicherweise Datentransformationen oder nichtparametrische Methoden erfordern.