


Der SQL-Vorteil für Datenabfragen
Dieser Leitfaden zeigt Datenanalysten und Wissenschaftlern, wie die Kernprinzipien von SQL schnellere, robustere und besser wartbare Datenpipelines ermöglichen als allgemeine Python-Skripte.
Einleitung: Die versteckten Kosten des „einfachen Durchlaufens“
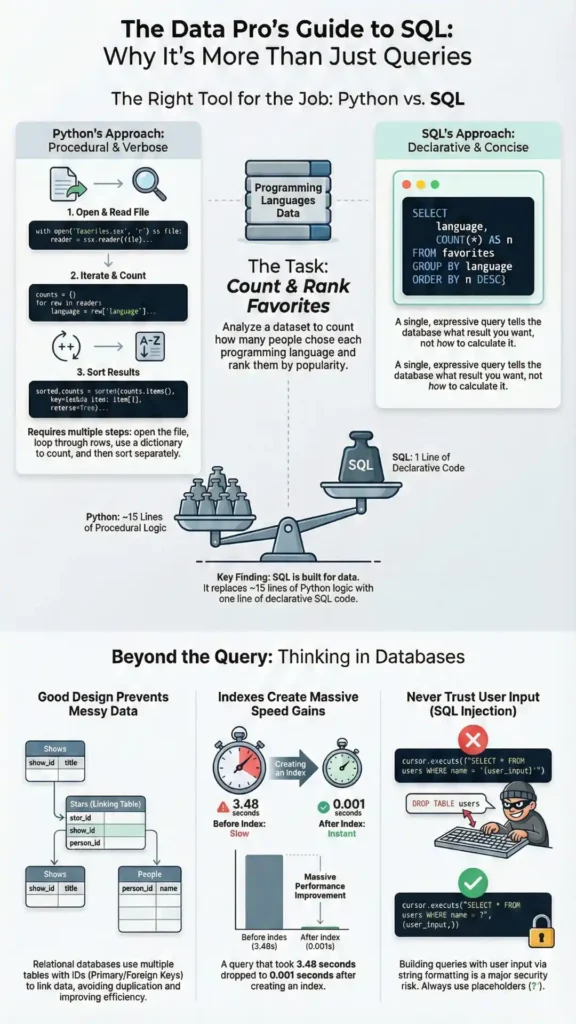
Für viele Datenexperten ist der Standardansatz beim Umgang mit neuen CSV-Dateien das Schreiben eines Python-Skripts. Wir öffnen die Datei, durchlaufen die Zeilen und erstellen manuell Zähler oder Listen, um scheinbar einfache Fragen zu beantworten. Das funktioniert zwar, führt aber oft zu langsamem, fehleranfälligem und schwer wartbarem Code. Schon wenige geänderte Spalten in der Quelldatei können das gesamte Skript zum Absturz bringen. Die Beantwortung einer etwas anderen Frage erfordert das Umschreiben komplexer Schleifen und Bedingungen. Dieser imperative, schrittweise Ansatz verschleiert eine leistungsfähigere, elegantere und effizientere Methode der Datenverarbeitung. Durch die Verwendung einer spezialisierten Sprache können wir komplexe Fragen einfacher formulieren und 17 Zeilen fehleranfälligen Python-Code durch eine einzige deklarative SQL-Zeile ersetzen.
Wichtigste Erkenntnis 1: Gestalten Sie Ihre Datenerfassung robust.
Eine der häufigsten Schwachstellen in einfachen Python-Datenskripten ist der Zugriff auf CSV-Spalten über ihren numerischen Index, wie zum Beispiel row[1]. This code is fragile because it makes a hard-coded assumption about the data’s structure. If a colleague opens the source spreadsheet and moves the second column to the third position, the script will either crash or, worse, silently produce incorrect results by processing the wrong data.
Eine robustere Lösung besteht darin, die in Python integrierten Funktionen zu verwenden. csv.DictReader. Instead of treating each row as a list of values, DictReader treats it as a dictionary where the keys are the column headers from the first row of the file. This allows you to access data by its meaningful name (e.g., row['language']), not its arbitrary position. The code will now work correctly even if the columns are reordered, as long as the header names remain the same.
Verbindung zur Datenwissenschaft: Diese Vorgehensweise macht Datenaufnahmepipelines deutlich robuster gegenüber Änderungen in den Quelldateien. Sie reduziert unerwartete Fehler, minimiert den Wartungsaufwand und stellt sicher, dass die Analyseergebnisse auf den korrekten Datenspalten basieren, wodurch die Zuverlässigkeit des gesamten Workflows verbessert wird.
Erkenntnis 2: Der Wandel hin zu einer deklarativen Denkweise
Ein grundlegender Unterschied zwischen Python und SQL liegt im Programmierparadigma, das sie fördern. Python ist in erster Linie Imperativ—Sie sagen es dem Computer wie Um eine Antwort Schritt für Schritt zu erhalten. Um die beliebtesten Programmiersprachen aus einer CSV-Datei zu zählen, beinhaltet der Python-Ansatz das Initialisieren von Zählervariablen, das Öffnen einer Datei, das Durchlaufen jeder Zeile und die Verwendung von if/elif statements to increment the correct counter. This process, which can take around 17 lines of code, is verbose and details a specific procedure.
SQL hingegen ist deklarativ—Sie erklären was Sie geben die gewünschte Antwort ein, und die Datenbank-Engine ermittelt den effizientesten Weg, diese zu erhalten. Dieselbe Zählaufgabe in SQL ist eine einzige Anweisung: SELECT language, COUNT(*) FROM favorites GROUP BY language;. This query doesn’t specify loops or conditionals; it simply states the desired result: a count of entries for each language. This shift from describing a process to describing an outcome is a powerful mental leap.
Verbindung zur Datenwissenschaft: Deklaratives Denken ermöglicht es Analysten, komplexe Datenfragen direkter und mit weniger Fehleranfälligkeit zu formulieren. Anstatt komplizierte Prozedurschleifen zu erstellen, können Sie sich auf die Definition der benötigten Daten konzentrieren, was zu klareren, besser lesbaren und präziseren Abfragen führt.
„…es scheint, als würden wir wahnsinnig viel Zeit damit verbringen, das hier aufzubauen, dabei wäre es schön, wenn wir den Code vereinfachen könnten… es wäre schön, das super schnell beantworten zu können…“ – Harvard CS50x 2025 (YouTube) – Vorlesung: SQL
Erkenntnis 3: Eine gute Datenstruktur ist kein Zufall.
Die Struktur Ihrer Daten hat einen erheblichen Einfluss auf Ihre Fähigkeit, diese korrekt und effizient zu analysieren. Ein häufiger Fehler, der anhand einer Tabellenkalkulation für die Fernsehserie „The Office“ veranschaulicht wird, ist die mangelhafte Speicherung zusammengehöriger Daten. Ein schlechtes Design besteht darin, für jeden Star eine neue Spalte hinzuzufügen (star1, star2, etc.), which is inflexible and doesn’t scale. Another flawed approach is to have a row for each star, repeating the show’s title (“The Office”) over and over again, creating massive data redundancy.
Die Lösung ist ein zentrales Datenbankkonzept namens NormalisierungStatt einer einzigen unübersichtlichen Tabelle teilen Sie die Daten in separate Tabellen für verschiedene Entitäten auf. Zum Beispiel erstellen Sie eine shows table for TV shows and a people table for actors. You then create a third “join table,” stars, that links them together using their unique IDs (show_id und person_id).
Dieses Design beseitigt Redundanz, indem lange Textzeichenfolgen variabler Länge wie „The Office“ durch kleine Ganzzahlen fester Größe (z. B. eine 32-Bit- oder 64-Bit-ID) ersetzt werden. Dadurch wird erheblich Speicherplatz gespart und die Leistung verbessert.
Verbindung zur Datenwissenschaft: Die Normalisierung bietet ein leistungsstarkes mentales Modell für die Datenbereinigung und -strukturierung. Das Erkennen und Beheben von Redundanzen in unstrukturierten Datensätzen (wie Tabellenkalkulationen) hilft, Analysefehler zu vermeiden und sicherzustellen, dass Aggregationen und Joins korrekte Ergebnisse liefern. Sie ist ein grundlegender Schritt für die Aufbereitung von Daten für zuverlässige Analysen.
Erkenntnis 4: Die Ein-Zeilen-Leistungsoptimierung
Langsame Abfragen stellen einen erheblichen Engpass bei der Datenanalyse dar, insbesondere bei großen Datensätzen mit komplexen Beziehungen. Eine Abfrage, die drei Tabellen verknüpfte, um alle Fernsehsendungen von Steve Carell zu finden, dauerte in der Vorlesung beispielsweise quälend lange 3.483 Sekunden. Diese Verzögerung entsteht, weil die Datenbank ohne weitere Steuerung eine lineare Suche durchführt – sie prüft jede einzelne Zeile einer Tabelle auf Übereinstimmungen.
Die Lösung besteht darin, einen zu erstellen INDEX on the column being searched. An index is a special data structure, much like the index at the back of a book, that allows the database to find specific rows almost instantly without scanning the entire table. By running a command like CREATE INDEX name_index ON people (name), you instruct the database to build an efficient lookup structure (typically a B-tree). In the lecture’s example, creating two indexes reduced a query for Steve Carell’s shows from 0.215 seconds to just 0.001 seconds—a massive performance gain.
Der Nachteil besteht darin, dass Indizes mehr Speicherplatz benötigen und Schreibvorgänge leicht verlangsamen können (INSERT, UPDATE, DELETE), as the index must also be updated. However, for read-heavy analytical workloads, the benefit to SELECT speed is almost always worth it.
Verbindung zur Datenwissenschaft: Das Verständnis von Indizes bietet Datenexperten ein einfaches und wirkungsvolles Werkzeug zur Behebung von Leistungsengpässen. Bei langsamen Abfragen großer Datensätze ist das Erstellen eines Index auf den gefilterten Spalten oft der erste und effektivste Optimierungsschritt.
Wichtigste Erkenntnis 5: Hören Sie auf, Benutzereingaben blind zu vertrauen.
Das Erstellen von Abfragen durch direktes Einfügen von Benutzereingaben in einen String, beispielsweise mit Pythons f-Strings, erzeugt eine schwerwiegende Sicherheitslücke, die als SQL-Injection-Angriffbekannt ist . Dieser tritt auf, wenn ein böswilliger Benutzer Eingaben bereitstellt, die als Teil des SQL-Befehls selbst ausgeführt werden.
Das klassische Beispiel ist ein Anmeldeformular. Wenn der Code eine Abfrage wie die folgende erstellt: f"SELECT * FROM users WHERE username = '{username}'", a user could enter a username of admin' --. The single quote closes the string, and the -- starts a SQL comment, causing the rest of the original query (including the password check) to be ignored. The database is tricked into logging the user in as ‘admin’ without a valid password. This is famously alluded to in the “Little Bobby Tables” webcomic.
Die Lösung ist zu immer Verwendung parametrisierte AbfragenAnstatt f-Strings zu verwenden, verwendet man einen Platzhalter (wie z. B. ?) in your SQL string. You then provide the user’s input as a separate argument. The database library ensures that the input is treated strictly as data and never as executable code, completely preventing SQL injection attacks.
Verbindung zur Datenwissenschaft: Dies ist eine unerlässliche Sicherheitsmaßnahme für alle, die interaktive Datenanwendungen, Dashboards oder Tools entwickeln, die Datenbanken anhand von benutzerdefinierten Filtern oder Eingaben abfragen. Werden Abfragen nicht parametrisiert, sind Ihre Daten und Systeme einem erheblichen Risiko ausgesetzt.
Was Sie heute bewerben sollten
- Beim Einlesen einer CSV-Datei in Python verwenden Sie
csv.DictReaderinstead of accessing columns by number. - Bevor Sie eine Python-Schleife zum Aggregieren von Daten schreiben, fragen Sie sich: „Könnte dies ein einzelnes sein?“
GROUP BYquery in SQL?” - Wenn Sie denselben Textwert viele Male in einer Tabelle sehen, sollten Sie die Daten in zwei Tabellen aufteilen, die durch eine eindeutige ID miteinander verknüpft sind.
- Sollten Sie jetzt aufgefordert werden, ein
SELECTquery with aWHEREclause is slow, create anINDEXon the column(s) in theWHEREclause. - Verwenden Sie niemals f-Strings oder Stringverkettung, um Benutzereingaben zu einer SQL-Abfrage hinzuzufügen. Verwenden Sie immer Platzhalter.
Schließen
Obwohl es naheliegend ist, für jede Aufgabe auf eine universelle Programmiersprache wie Python zurückzugreifen, zeigt diese Vorlesung aus dem Kurs CS50, dass grundlegende Konzepte der Informatik im Umgang mit Daten starke praktische Vorteile bieten. Diese Vorlesung ist Teil einer umfassenden Reihe, die verdeutlicht, wie grundlegende Themen der Informatik die Qualität und Effizienz der Datenanalyse direkt verbessern. Durch die Nutzung der deklarativen Natur von SQL, solider Datenmodellierungsprinzipien und Leistungsmerkmale können Datenexperten Code schreiben, der nicht nur schneller, sondern auch robuster und leichter verständlich ist.
Welche routinemäßige Datenaufgabe, die Sie in Python ausführen, könnte stattdessen mit einer einzigen, deklarativen SQL- Abfrage gelöst werden?




