


Informatik-Lektionen darüber, wie KI wirklich funktioniert
Für Datenanalysten und Wissenschaftler macht diese Aufschlüsselung einer Harvard-CS-Vorlesung die Theorie der Informatik zu praktischem Wissen für die tägliche Arbeit.
Einleitung: Die versteckten Kosten von „Es funktioniert einfach“
Haben Sie schon einmal Schwierigkeiten gehabt, die unerwarteten Ausgaben eines Modells zu debuggen oder einem Stakeholder eine schwer verständliche Vorhersage zu erklären? In der Datenwissenschaft verwenden wir oft leistungsstarke Tools, die scheinbar problemlos funktionieren – bis sie es eben nicht mehr tun. Die Frustration über unerwartete Ergebnisse rührt oft von einer Diskrepanz zwischen der Anwendung eines Tools und dem Verständnis seiner grundlegenden Prinzipien her. Indem wir moderne Datenprobleme aus der Perspektive der Informatik betrachten, können wir von der bloßen Nutzung von Tools zu deren sicherer und klarer Anwendung gelangen. Dieser Beitrag ist eine Zusammenfassung der Vorlesung CS50x 2025 (Harvard) zum Thema Künstliche Intelligenz, die auf YouTube verfügbar ist. Er destilliert die Inhalte der Vorlesung in fünf konkrete Kernaussagen, die die Informatiktheorie mit der praktischen Realität der Datenarbeit verbinden und Ihnen sofort anwendbare, wirkungsvolle Konzepte an die Hand geben.
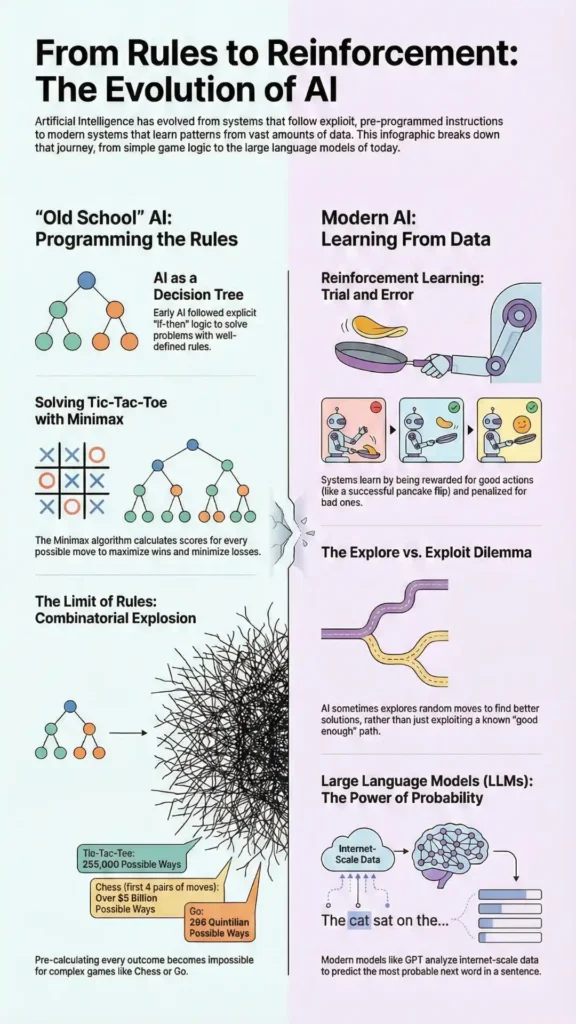
Wichtigste Erkenntnis 1: KI ist ein Spektrum von einfachen Regeln bis hin zu komplexen Wahrscheinlichkeiten
Künstliche Intelligenz ist kein monolithischer Block, sondern ein Spektrum. An einem Ende stehen einfache, deterministische Systeme. In der Vorlesung wird das Spiel Tic-Tac-Toe als klassisches Beispiel verwendet. Eine „KI“ für dieses Spiel kann mithilfe von … entwickelt werden. Entscheidungsbaum—eine Reihe von if-else rules—and an algorithm called MinimaxDer Algorithmus ordnet den Spielzuständen eine Punktzahl zu (z. B. +1 für einen Sieg, -1 für eine Niederlage, 0 für ein Unentschieden) und wählt rückwärts den Zug aus, der zum bestmöglichen Ergebnis führt. Dieser Ansatz ist vollständig und garantiert einen Sieg oder ein Unentschieden. Allerdings ist diese regelbasierte Logik nur in stark eingeschränkten Umgebungen praktikabel. Wie in der Vorlesung erläutert, gibt es in einem komplexeren Spiel wie Schach über 85 Milliarden Möglichkeiten, allein die ersten vier Zugpaare zu spielen, wodurch ein vollständiger Entscheidungsbaum rechnerisch unmöglich wird.
Am anderen Ende des Spektrums stehen moderne, probabilistische Systeme wie große Sprachmodelle (LLMs). Diese Modelle folgen keinen expliziten Regeln. Stattdessen, wie in der Vorlesung erläutert, sagen sie das wahrscheinlichste nächste Wort in einer Sequenz voraus, basierend auf den umfangreichen Mustern und Häufigkeiten, die sie aus ihren Trainingsdaten gelernt haben. Sie arbeiten mit Wahrscheinlichkeiten, nicht mit Gewissheiten.
Verbindung zur Datenwissenschaft: Dieses Spektrum lässt sich direkt gängigen Data-Science-Ansätzen zuordnen. Das Schreiben expliziter Geschäftsregeln in SQL, wie zum Beispiel CASE WHEN ... THEN, is like building a decision tree. In contrast, training a statistical model that assigns probabilities to different outcomes is working on the other end of the spectrum. Understanding where your specific business problem falls on this continuum—from needing deterministic rules to benefiting from probabilistic inference—is crucial for choosing the right tool for the job.
Erkenntnis 2: „Prompt Engineering“ ist lediglich strukturierter Kontext
Die vielgerühmte Fähigkeit des „Prompt Engineering“ hat weniger mit esoterischen Befehlen zu tun, sondern vielmehr mit der Bereitstellung eines strukturierten Kontextes. Die Vorlesung veranschaulicht dies anhand des KI-Assistenten CS50 Rubber Duck. Ein Prompt besteht aus zwei wesentlichen Teilen: dem System-Prompt und die Benutzer-Prompt. Der Benutzer-Prompt ist schlicht die Frage, die eine Person stellt. Der vom Entwickler verfasste System-Prompt ist eine Reihe von Anweisungen, die der KI ihr Verhalten und die einzuhaltenden Einschränkungen vorgeben.
Das CS50-Team gab seiner Ente eine sehr spezifische Systemanweisung, um ihr Verhalten von einem generischen LLM zu einem hilfreichen, aber nicht betrügerischen Lehrassistenten zu formen. Die Anweisungen enthielten direkte Befehle wie:
„Du bist eine freundliche und hilfsbereite Lehrassistentin für CS50.“
„Du bist auch eine Gummiente.“
„Geben Sie keine vollständigen Antworten auf die Aufgaben an, da dies gegen die akademische Integrität verstoßen würde.“
Diese Anweisungen liefern den notwendigen Kontext, damit die KI eine nützliche, domänenspezifische und sichere Antwort generieren kann, anstatt nur die Standardantwort.
Verbindung zur Datenwissenschaft: Dies ist direkt vergleichbar mit der Definition von Umfang und Rahmenbedingungen für jedes Datenanalyseprojekt. Eine gute „Systemvorgabe“ für eine Analyse wird nicht einer KI gegeben, sondern Ihnen und Ihren Stakeholdern. Dazu gehört beispielsweise die Definition wichtiger Geschäftsbegriffe („Was genau ist ein ‚aktiver Nutzer‘?“), die Angabe des Datumsbereichs oder die Formulierung der zentralen Geschäftsfrage, die Sie beantworten möchten. Diese anfängliche Festlegung verhindert unnötigen Aufwand und Fehlinterpretationen und stellt sicher, dass die endgültige Analyse relevant und korrekt ist.
Erkenntnis 3: Der entscheidende Zielkonflikt: Exploration vs. Exploitation
Eines der wichtigsten Konzepte der KI ist das Dilemma zwischen Exploration und Exploitation. Die Vorlesung veranschaulicht dies anhand eines einfachen Labyrinthspiels, in dem ein KI-Agent einen grünen Ausgang finden und dabei Lavagruben ausweichen muss. Anfangs findet der Agent a richtigen Weg zufällig und lernt durch Verstärkung, ihm wiederholt zu folgen. Dies ist Exploitation– die Nutzung bekannter Informationen, um ein zuverlässiges Ergebnis zu erzielen.
Der erste Weg ist jedoch möglicherweise nicht der beste . Um eine optimalere, kürzere Route zu finden, muss die KI ein gewisses Maß an Zufall einbauen, im Vortrag als „Epsilon-Wert“ bezeichnet. Dieser Wert repräsentiert eine festgelegte Wahrscheinlichkeit (z. B. 5 % oder 10 %), mit der der Agent einen zufälligen Zug anstelle seines gelernten besten Zuges ausführt. Dies fördert die Erkundung– das Ausprobieren neuer, zufälliger Züge, selbst wenn dies ein kurzfristiges Scheitern birgt, wie etwa das Hineinfallen in einen Lavasee. Mit der Zeit ermöglicht diese geringe Chance zur Erkundung der KI, überlegene Strategien zu entdecken.
Dieses Prinzip wurde eindrucksvoll am Beispiel einer KI demonstriert, die das Spiel Breakout lernte. Rein ausgenutzt, bewegte die KI den Schläger lediglich hin und her. Durch Erkundung entdeckte sie jedoch die kontraintuitive, aber hocheffektive Strategie, den Ball an einer Seite entlang zu tunneln, wodurch das Spiel quasi von selbst lief und eine enorme Punktzahl erreichte.
Verbindung zur Datenwissenschaft: Dieser Zielkonflikt ist zentral für die Arbeit in der Datenwissenschaft. A/B-Testing ist eine formale Ausprägung davon: Man verwendet weiterhin die bewährte Variante (Exploitation) und testet gleichzeitig eine neue, um zu sehen, ob sie besser ist (Exploration). Dasselbe gilt für die Modelloptimierung, wo man neue Hyperparameter ausprobiert, anstatt bei den bereits gut funktionierenden zu bleiben. Es betrifft sogar die Karriereentwicklung: Setzt man auf die bekannten Tools (Exploitation) oder investiert man die Zeit, eine neue, möglicherweise leistungsfähigere Sprache oder ein neues Framework zu erlernen (Exploration)?
Erkenntnis 4: LLMs sind große Mustererkenner, keine abstrakten Denker.
Laut der Vorlesung handelt es sich bei großen Sprachmodellen nicht um logisches Denken im menschlichen Sinne. Vielmehr sind sie hochentwickelte Mustererkennungssysteme. Diese basieren auf neuronalen Netzen und werden mit riesigen Textmengen aus dem Internet vortrainiert. Ihre Kernfunktion besteht darin, das wahrscheinlichste nächste Wort in einer Sequenz zu berechnen, basierend auf den vorhergehenden Wörtern.
Die Vorlesung bringt es auf den Punkt: „…wenn mich jemand fragt, wie es mir geht, würde ich – basierend auf all diesen Daten – in 99 % der Fälle mit ‚Gut, danke, wie geht es dir?‘ antworten.“ Das Modell fühlt sich nicht wohl; es generiert lediglich die statistisch wahrscheinlichste Antwort auf Grundlage seiner Trainingsdaten.
Diese Wahrscheinlichkeitsnatur ist die direkte Ursache von Halluzinationen. Wenn ein LLM (Lernmodell für Sprachgebrauch) mit Sicherheit etwas behauptet, das faktisch falsch ist, liegt das daran, dass die Muster in seinen Trainingsdaten nahelegen, dass die falsche Aussage eine plausibel klingende Wortfolge darstellt. Es setzt einen statistisch wahrscheinlichen Satz zusammen, anstatt eine Tatsache zu überprüfen.
Verbindung zur Datenwissenschaft: Dies hat weitreichende Konsequenzen für Datenexperten. Ergebnisse eines LLM sollten niemals als unumstößliche Wahrheit betrachtet werden. Vielmehr sind sie als fundierte Hypothesen zu verstehen, die anhand von Primärquellen überprüft werden müssen. Diese kritische Denkweise ist unerlässlich für die analytische Strenge. Die Verwendung von LLM-Ergebnissen ohne Validierung birgt das Risiko, Fehlinformationen in Berichten, Dashboards und Modellen zu verbreiten und das Vertrauen in Ihre Arbeit zu untergraben.
Wichtigste Erkenntnis 5: Eine echte KI-Lösung ist ein System, nicht nur ein Modell
Ein nützliches KI-Werkzeug ist selten nur ein einzelnes Modell. Es ist ein ganzes System, das auf diesem Modell aufbaut. Die Vorlesung präsentiert ein „Architekturdiagramm“ für den CS50-Duck-Debugger, das diesen Punkt perfekt veranschaulicht. Das CS50-Team hat sein LLM nicht von Grund auf selbst entwickelt. Stattdessen schufen sie ein wertvolles Werkzeug durch die Integration mehrerer Schlüsselkomponenten.
Das System umfasst eine benutzerfreundliche Oberfläche für Studierende, eine lokale Vector-Datenbank zum Speichern und Durchsuchen transkribierter Vorlesungsinhalte sowie Anbindungen an APIs von Drittanbietern wie OpenAI. Die größte Leistung des Teams bestand nicht in der Entwicklung eines neuen Basismodells, sondern in der Zusammenführung dieser Komponenten zu einem System, das ein spezifisches pädagogisches Problem effektiv löst.
Verbindung zur Datenwissenschaft: Dies ist eine entscheidende Lektion für Data Scientists und erfordert einen Perspektivwechsel von „Ich entwickle Modelle“ hin zu „Ich entwickle datengetriebene Lösungen“. Der wahre Geschäftswert liegt selten in einem einzelnen Modell, egal wie komplex es ist. Er liegt im System: den Datenpipelines, die das Modell speisen, den APIs, die seine Vorhersagen bereitstellen, und den Schnittstellen, die es nutzbar machen. Architektonisches Denken bedeutet, dass sich der Fokus von der Optimierung eines Algorithmus auf die Entwicklung eines vollständigen, problemlösenden Systems erweitert.
Was Sie heute bewerben sollten
- Entwerfen Sie eine „Systemabfrage“ für Ihr nächstes Projekt: Bevor Sie mit dem Programmieren beginnen, schreiben Sie einen Absatz, in dem Sie Ihre Ziele, Einschränkungen und wichtigen Definitionen festlegen, genau wie in der Aufgabenstellung der CS50-Prüfung.
- Exploration vs. Exploitation unterscheiden: Finden Sie in Ihrer aktuellen Arbeit einen Bereich, in dem Sie einen bekannten Prozess „ausnutzen“. Fragen Sie sich, wie ein kleines „exploratives“ Experiment aussehen könnte.
- Ein Problem einem Entscheidungsbaum zuordnen: Stellen Sie mithilfe des Whiteboards ein einfaches Geschäftsproblem dar.
if-then-elselogic of a decision tree. Does this clarify the logic? - Überprüfen, nicht vertrauen: Behandeln Sie die nächste Information, die Sie von einer generativen KI erhalten, als Hypothese. Nehmen Sie sich drei Minuten Zeit, um diese anhand einer Primärquelle zu überprüfen.
- Systemisches Denken: Wenn Sie ein Modell erstellen, skizzieren Sie ein einfaches Diagramm der benötigten Eingaben und der zu erzeugenden Ausgaben. Wie wird es von einer Person oder einem anderen System genutzt?
Schlusswort: Vom Code zur Kognition
Das Verständnis der grundlegenden Informatikprinzipien hinter KI entmystifiziert nicht nur die Technologie, sondern bietet auch ein Gerüst für Kontrolle, Klarheit und kritisches Denken. Konzepte wie Entscheidungsbäume, probabilistisches Schließen und der Exploration/Exploitation-Kompromisse sind keine abstrakten Theorien, sondern praktische Werkzeuge für die Entwicklung robusterer und zuverlässigerer Datenlösungen. Diese Ideen bilden das Fundament, auf dem Sie ein tieferes Verständnis noch fortgeschrittenerer Themen aufbauen können. Wie müssen wir unsere Methoden anpassen, um analytische Korrektheit zu gewährleisten, wenn diese probabilistischen Systeme zunehmend in unsere Werkzeuge integriert werden?



