


Was Datenwissenschaftler über das Gedächtnis vergessen
Ein Leitfaden für Datenanalysten und Wissenschaftler, um robusteren, effizienteren und besser vorhersagbaren Code zu schreiben, indem sie verstehen, wie der Speicher wirklich funktioniert.
Einleitung: Die Fehler, die nicht in Ihrer Logik liegen
Sie haben ein Python Das Skript läuft bei einer kleinen Datenstichprobe einwandfrei, stürzt aber mit einer kryptischen Fehlermeldung ab. MemoryError on the full dataset. Or maybe you’ve encountered a bug in a data pipeline that vanishes when you try to debug it step-by-step. These frustrating problems often have nothing to do with a flaw in your business logic and everything to do with a gap in understanding what the computer is doing “under the hood.”
Viele dieser komplexen und unvorhersehbaren Probleme haben ihren Ursprung in grundlegenden Konzepten der Informatik zum Thema Speicher. Diese zu verstehen ist nicht nur eine akademische Übung, sondern eine praktische Fähigkeit für die Entwicklung besseren und zuverlässigeren Codes. Dieser Beitrag fasst die Inhalte der Vorlesung „Speicher“ (CS50x 2025, Harvard University) zusammen, die auf YouTube verfügbar ist.
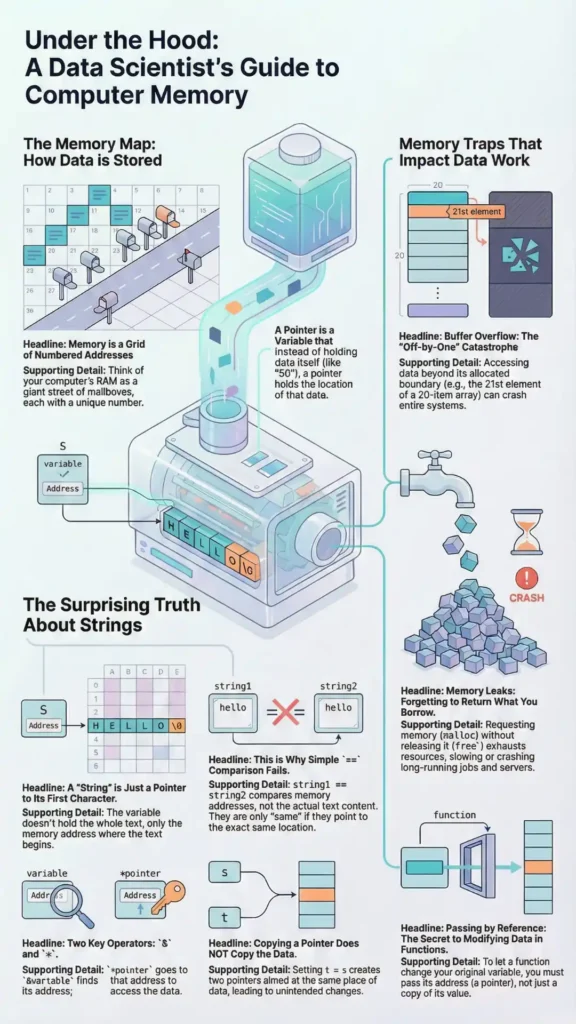
Erkenntnis 1: „Schnur“ ist eine Illusion
In vielen einführenden Kontexten, ein string is presented as a basic data type. The CS50 library, for instance, uses it as a helpful “training wheel” to get students started. However, in a foundational language like C, there is no built-in string data type. It’s an abstraction.
Was wir als Zeichenkette bezeichnen, ist eigentlich eine char *—a pointer to a character. This pointer is simply the memory address of the erste Zeichen in einer Sequenz. Um zu wissen, wo die Zeichenkette endet, verwendet C einen speziellen Sentinelwert: das Null-Terminatorzeichen (\0), a byte containing all zeros. Functions like printf read from the starting address character by character until they hit this null terminator. Without it, the function would just keep reading into adjacent memory, causing unpredictable behavior.
Verbindung zur Datenwissenschaft: Dieses Konzept bildet die Grundlage dafür, wie Hochsprachen wie Python und R Zeichenketten und andere Daten variabler Länge verarbeiten. Es erklärt, warum die Manipulation von Zeichenketten rechenintensiv sein kann; das System sucht häufig nach einem Endpunkt oder verwaltet zugrundeliegende Arrays. Für Datenwissenschaftler ist dies entscheidend beim Parsen von Textdateien oder der Arbeit mit APIs; ein fehlendes oder falsches Terminatorbyte kann zu Datenbeschädigung oder Parsing-Fehlern führen, beispielsweise dazu, dass eine Logdateizeile falsch gelesen wird und wichtige Fehlerinformationen abgeschnitten werden.
Zweiter Fazit: Warum == Can Lie About Equality
Wenn Sie zwei ganzzahlige Variablen in C vergleichen mit ==, you’re comparing their values. But if you compare two string variables with ==, you are not comparing their content. Instead, you are comparing their memory Adressen.
Wenn Sie zwei identische Zeichenketten haben, „high“ und „high“, diese aber an unterschiedlichen Speicherorten abgelegt sind, == operator will return false. Their content is the same, but their addresses are different. This is why C requires a special function like strcmp (string comparison), which performs a character-by-character check to determine if the strings’ values are truly identical.
Verbindung zur Datenwissenschaft: Dies ist eine direkte Parallele zum Konzept der Objektidentität versus Wertgleichheit in Python. is in Python compares memory addresses (identity), while == typically compares values (equality). For complex objects like Pandas DataFrames, even == can be ambiguous. This is why dedicated methods like pandas.DataFrame.equals() exist. The fundamental C behavior explains why you can’t just compare two DataFrames with a simple operator; you need a robust method that iterates through and compares their actual contents, just like strcmp does for C strings.
Erkenntnis 3: Eine Kopie könnte nur ein Alias sein
In C ist eine Anweisung wie string t = s; might look like it’s creating a new copy of string s and naming it t. It is not. This operation does not copy the string’s content (the characters ‘H’, ‘I’, ‘!’, ‘\0’). It only copies the Adresse des ersten Zeichens der Zeichenkette.
Das bedeutet, dass beide Variablen s und t, now point to the exact same block of memory. They are two different names for the same underlying data. Consequently, if you modify the string using the variable t (for example, by capitalizing the first letter), you are also changing the string for s. There is only one string, and both variables point to it.
Verbindung zur Datenwissenschaft: Hier liegt die Wurzel des Problems „Ansicht vs. Kopie“, das Pandas-Nutzer häufig verwirrt. Ein Data Scientist filtert möglicherweise einen DataFrame, weist ihn einer neuen Variable zu und beginnt mit den Änderungen, in der Annahme, an einer unabhängigen Kopie zu arbeiten. Gibt Pandas jedoch eine „Ansicht“ zurück (einen Alias, der auf die Originaldaten verweist), verändert er unbeabsichtigt seinen Quelldatensatz. Dies kann zu subtilen, gefährlichen Fehlern führen, die schwer aufzuspüren sind, da die Originaldaten durch eine an anderer Stelle durchgeführte Operation „mysteriöserweise“ verändert werden.
„Wenn man mit dem einfachen Vergleichsoperator zwei Zeichenketten vergleicht … also die beiden Zeichenketten, also die beiden Adressen, vergleicht, dann sind sie offensichtlich an unterschiedlichen Stellen … Wir brauchten eine Lösung dafür, und deshalb haben wir die Funktion `stir comp` eingeführt, die dieses Problem korrekt löst.“ – Harvard CS50x 2025 (YouTube) – Vorlesung: Speicher
Erkenntnis 4: Speicherplatz ist eine begrenzte Ressource, die Sie verwalten müssen.
Benötigt ein Programm während seiner Laufzeit Speicher – beispielsweise zum Speichern von Daten, die aus einer Datei gelesen wurden –, kann es diesen vom Betriebssystem anfordern. In C geschieht dies mit einer Funktion namens `getInteger`. malloc() (memory allocation), which asks for a specific number of bytes from a large memory pool called the “heap.”
Diese Anfrage kann jedoch fehlschlagen. Wenn dem System nicht genügend Arbeitsspeicher zur Verfügung steht, malloc() will return NULL (a special pointer to address zero) to signal failure. Robust code must always check for this possibility. Furthermore, once the program is finished with that memory, it must explicitly return it to the system using free(). Failing to do so creates a “memory leak,” where the program holds onto memory it no longer needs, potentially causing it to run out of resources and crash over time.
Verbindung zur Datenwissenschaft: Dies gilt unmittelbar für die Arbeit mit großen Datensätzen. Der Versuch, eine riesige CSV- oder Parquet-Datei in einen Pandas DataFrame zu laden, kann leicht zum Absturz eines Skripts führen, wenn es mehr Speicher anfordert, als dem System zur Verfügung steht. Die Prinzipien von malloc und free are fundamental to writing scalable data pipelines, understanding why certain processes are “memory-bound,” and appreciating the design of modern data tools that use techniques like chunking or memory mapping to process data that won’t fit into memory all at once.
Erkenntnis 5: Funktionen haben private Arbeitsbereiche (den Stack)
Wenn eine Funktion aufgerufen wird, erhält sie ihren eigenen privaten Arbeitsbereich in einem Speicherbereich, der als „Stack“ bezeichnet wird. Dieser „Stack-Frame“ enthält ihre lokalen Variablen, einschließlich der an sie übergebenen Argumente.
Die CS50-Vorlesung veranschaulicht dies anhand eines swap function intended to swap two integer values. The initial version fails because it only swaps Kopien der Werte innerhalb ihres eigenen privaten Stack-Frames. Dies wird als „Wertübergabe“ bezeichnet. Sobald die Funktion beendet ist, verschwindet ihr Stack-Frame, und die ursprünglichen Variablen in der aufrufenden Funktion (main) are left completely unchanged. The corrected version works by “pass by reference”—passing the memory Adressen der ursprünglichen Variablen. Dies ergibt die swap function the power to reach back into the caller’s stack frame and modify the original variables directly.
Verbindung zur Datenwissenschaft: Dieses Konzept ist entscheidend für das Verständnis von Gültigkeitsbereich und Veränderbarkeit von Variablen beim Schreiben von Datentransformationsfunktionen. Es erklärt, warum eine Funktion einen übergebenen DataFrame möglicherweise nicht wie erwartet verändert (z. B. wenn sie die Variable intern neu zuweist, anstatt das Objekt direkt zu verändern). Es unterstreicht außerdem die Designprinzipien von „reinen Funktionen“ – Funktionen, die ihre Eingaben nicht verändern –, welche für die Erstellung reproduzierbarer, testbarer und fehlerfreier Analyse-Pipelines unerlässlich sind.
Erkenntnis 6: Der Milliarden-Dollar-Fehler ist ein Off-by-One-Fehler
Ein „Pufferüberlauf“ tritt auf, wenn ein Programm versucht, Daten über die Grenzen eines Speicherpuffers (z. B. eines Arrays) hinaus zu schreiben. Das ist vergleichbar mit dem Versuch, einen Liter Wasser in ein kleines Glas zu gießen – der Überschuss muss irgendwohin und überschreibt dabei oft angrenzenden Speicher, was zu Datenbeschädigung und Abstürzen führt.
Die Vorlesung bezieht sich auf einen realen Vorfall mit der Sicherheitssoftware CrowdStrike. Ein Fehler in einem Update führte weltweit zum Systemausfall. Die Ursache war erstaunlich einfach: Der Code erwartete ein Array mit 20 Werten, erhielt aber 21. Der Versuch, auf das nicht vorhandene 21. Element zuzugreifen, führte zu einem Speicherzugriffsfehler („Out-of-Bounds-Read“) und damit zum Systemabsturz. Da C keinen automatischen Schutz gegen solche Fehler bietet, demonstriert dieser Fall eindrucksvoll eine gefährliche Fehlerklasse.
Verbindung zur Datenwissenschaft: Dies ist die ultimative Lektion in defensiver Programmierung für die Datenverarbeitung. Beim Parsen von Dateien, Iterieren über Listen oder Verarbeiten von API-Antworten können Sie sich nicht darauf verlassen, dass die eingehenden Daten Ihren Erwartungen entsprechen. Diese grundlegende Schwachstelle verdeutlicht die hohe Bedeutung einer robusten Fehlerbehandlung und Eingabevalidierung. Fügen Sie daher vor der Datenverarbeitung stets explizite Prüfungen auf erwartete Formate, Größen und Grenzen hinzu, um zu verhindern, dass Ihre gesamte Pipeline aufgrund eines einzigen unerwarteten Wertes abstürzt.
Was Sie heute bewerben sollten: Eine praktische Checkliste
- Hinterfragen Sie Ihre Gleichstellungsprüfungen: Beim Vergleich komplexer Objekte wie Modelle oder DataFrames sollten Sie innehalten und prüfen, ob Sie wissen müssen, ob es sich um die richtigen handelt. genau dasselbe Objekt im Gedächtnis (Identität) oder wenn sie einfach enthalten die gleichen Daten (Gleichheit). Verwenden Sie die geeignete Methode (
isund.equals()) for your goal. - Überprüfen Sie Ihre DataFrame-Änderungen: Bevor Sie eine vermeintliche Kopie eines DataFrames ändern, prüfen Sie explizit, ob es sich um eine Ansicht oder eine Kopie handelt. Eine einfache Änderung an einer Ansicht kann Ihr ursprüngliches Dataset unbemerkt beschädigen.
.copy()to ensure you have an independent object. - Seien Sie proaktiv in Bezug auf Speicher: Beim Arbeiten mit großen Dateien sollten Sie diese nicht einfach laden und auf das Beste hoffen. Verwenden Sie Tools, um den verfügbaren Arbeitsspeicher zu überprüfen und die Dateien in kleineren Teilen zu verarbeiten (z. B. mithilfe von …).
chunksizeinpandas.read_csv) to avoid requesting more memory than is available. - Datengrenzen validieren: Wenn Sie auf Daten über einen Index zugreifen, beispielsweise in einer Liste oder einem Array, betrachten Sie dies immer als potenzielle Fehlerquelle. Fügen Sie Prüfungen hinzu, um sicherzustellen, dass der Index im erwarteten Bereich liegt, insbesondere wenn die Datengröße von einer externen Quelle abhängt.
- Vertrauen Sie niemals den Eingabedaten: Behandeln Sie Daten aus Dateien, APIs oder Benutzereingaben grundsätzlich als unzuverlässig. Fügen Sie vor der Durchführung von Operationen Zusicherungen oder explizite Prüfungen auf Datentypen, -größen und -formate hinzu, um unerwartete Probleme zu erkennen, bevor sie Ihre Analyse beeinträchtigen.
9. Schlussgedanken
Diese grundlegenden Speicherkonzepte sind nicht bloß akademisches Beiwerk; sie treten direkt als Fehler, Leistungsengpässe und Sicherheitsrisiken zutage, denen wir in der anspruchsvollen Datenwissenschaft begegnen. Indem wir verstehen, was im Speicher geschieht, können wir von der Symptombetrachtung zur Diagnose der eigentlichen Ursache gelangen. Im Verlauf des CS50-Kurses bilden diese Prinzipien die Grundlage für die Entwicklung effizienter Datenstrukturen, die unseren Datenbanken und Algorithmen zugrunde liegen.
Welcher kürzlich aufgetretene, „seltsame“ Fehler in Ihrem Code könnte nun durch eines dieser grundlegenden Speicherprinzipien erklärt werden?





