


Datenstrukturen: Ein Leitfaden für Datenwissenschaftler
Dieser Beitrag hilft Datenexperten, grundlegende Datenstrukturen zu verstehen, um schnelleren und speichereffizienteren Code zu schreiben.
Ein häufiger Flaschenhals in Datenverarbeitungsskripten, von trägen Feature-Engineering-Schleifen bis hin zu ineffizienten Suchvorgängen, lässt sich oft auf eine Diskrepanz zwischen der Aufgabe und der verwendeten Datenstruktur zurückführen. Die Ursache dieser Performance-Probleme liegt häufig nicht in der Logik des Codes, sondern in der Speicherorganisation der Daten. Das Verständnis dieser Strukturen – und ihrer Vor- und Nachteile – ist eine grundlegende Fähigkeit für die Entwicklung effizienter und skalierbarer Analyse-Pipelines. Dieser Beitrag fasst die wichtigsten Erkenntnisse zu Datenstrukturen aus dem renommierten CS50x-Kurs der Harvard University zusammen und verknüpft diese Grundlagen der Informatik direkt mit der praktischen Welt der Datenanalyse und Data Science. Dieser Beitrag basiert auf dem CS50x-Kurs 2025 (Harvard) auf YouTube.
1. Arrays und ihre versteckten Kosten für Größenänderungen
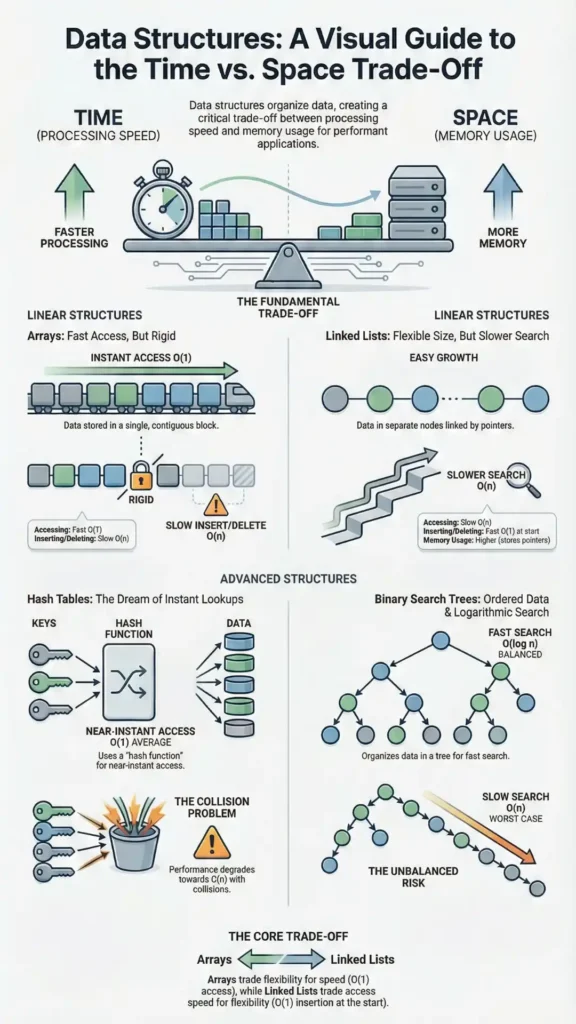
Ein Array ist eine einfache Datenstruktur, in der Elemente desselben Typs im Speicher direkt hintereinander („zusammenhängend“) abgelegt werden. Durch diese zusammenhängende Anordnung ist der Zugriff auf jedes Element über seinen Index extrem schnell. Arrays haben jedoch eine entscheidende Einschränkung: Ihre Größe muss im Voraus festgelegt werden.
Was passiert, wenn ein bereits volles Array vergrößert werden muss? Man kann nicht einfach ein neues Element am Ende hinzufügen, wenn der Speicherplatz bereits belegt ist. Die einzige Lösung besteht darin, einen komplett neuen, größeren Speicherblock zu allokieren, jedes einzelne Element manuell vom alten in das neue Array zu kopieren und anschließend den vom ursprünglichen Array belegten Speicher freizugeben. Dieser Kopiervorgang ist ein zeitaufwändiger, linearer Vorgang – je größer das Array, desto länger dauert er.
Verbindung zur Datenwissenschaft
Viele gängige Datenwerkzeuge, wie beispielsweise Python-Listen, verhalten sich wie „dynamische Arrays“. Obwohl sie scheinbar automatisch wachsen, führen sie diese aufwändige Größenänderung im Hintergrund durch. Um das Hinzufügen von Elementen zu beschleunigen, verwenden Python-Listen eine Überallokation– sie reservieren zusätzlichen Speicherplatz –, was zu einer amortisierten konstanten Zeit (amortisierte O(1)) für das Hinzufügen führt. Das Einfügen eines Elements am Anfang einer großen Liste ist jedoch nicht nur aufgrund der potenziellen Größenänderung langsam, sondern auch, weil jedes nachfolgende Element um eine Position nach rechts verschoben werden muss, was einen direkten Aufwand von O(n) verursacht.
2. Verkettete Listen: Zusammenhängender Speicher gegen Flexibilität
Eine verkettete Liste bietet eine Lösung für das Problem der starren Größenänderung von Arrays. Anstatt Elemente zusammenhängend zu speichern, besteht eine verkettete Liste aus einer Reihe von „Knoten“, die an beliebiger Stelle im Speicher platziert werden können. Jeder Knoten enthält zwei Dinge: Daten und einen Zeiger (eine Adresse), der auf den Speicherort des nächsten Knotens verweist. Dadurch lassen sich verfügbare Speicherbereiche nach Bedarf miteinander verknüpfen.
Diese Struktur birgt einen grundlegenden Zielkonflikt:
- Oberseite: Die Liste kann dynamisch wachsen und schrumpfen, ohne dass alle vorhandenen Elemente verschoben werden müssen. Dies ermöglicht eine effizientere Nutzung des fragmentierten Speichers.
- Nachteil: Insgesamt wird mehr Speicherplatz benötigt, da für jedes einzelne Element ein zusätzlicher Zeiger benötigt wird, um die Adresse des nächsten Elements zu speichern.
- Kritischer Nachteil: Die Möglichkeit einer schnellen binären Suche geht verloren. Da die Elemente nicht zusammenhängend gespeichert sind, kann man nicht direkt zur Mitte der Liste springen; man muss sie Knoten für Knoten vom Anfang an durchlaufen.
Verbindung zur Datenwissenschaft
Betrachten wir ein Echtzeit-Ereignisprotokoll, in dem Ereignisse je nach Aktualisierungen mitten in einer Sequenz eingefügt oder entfernt werden müssen. Ein Standard-Python-Implementierungsprogramm list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from beide endet.
3. Die kontraintuitive Wahrheit: Die schnellste Liste wird rückwärts erstellt.
Bei der Arbeit mit verketteten Listen hat die Art und Weise, wie neue Elemente hinzugefügt werden, einen erheblichen Einfluss auf die Performance. Um einen neuen Knoten am Anfang der Liste einzufügen (Präfixierung), genügt es, den neuen Knoten zu erstellen und einige Zeiger am Anfang der Liste zu aktualisieren. Diese Operation ist unabhängig von der Gesamtgröße der Liste.
Das Einfügen am Anfang der Liste ist daher eine Operation konstante Zeit (O(1)) – sie ist extrem schnell. Umgekehrt muss man zum Hinzufügen eines neuen Knotens am Ende der Liste (Anhängen) zunächst die gesamte Liste vom Anfang an durchlaufen, um den letzten Knoten zu finden. Daher ist das Anhängen eine Operation linear time (O(n)) , die mit zunehmender Länge der Liste immer langsamer wird.
Das überraschende Ergebnis ist, dass die effizienteste Methode zum Erstellen einer verketteten Liste darin besteht, jedes neue Element am Anfang einzufügen. Das bedeutet: Fügt man die Zahlen 1, dann 2 und schließlich 3 ein, so lautet die endgültige Liste im Speicher 3 -> 2 -> 1.
Verbindung zur Datenwissenschaft
Dies ist ein klassisches Beispiel dafür, wie eine scheinbar einfache Entscheidung – das Hinzufügen am Anfang oder am Ende – massive Auswirkungen auf die Performance haben kann (O(1) vs. O(n)). Dies unterstreicht, wie wichtig es ist, die Zeitkomplexität der Operationen zu verstehen, die wir täglich in Skripten zur Datenbereinigung und zum Feature Engineering verwenden. Eine langsam laufende Schleife kann eine Operation mit linearer Laufzeit verbergen, die optimiert werden könnte.
4. Binäre Suchbäume: Schnelle Suchvorgänge, die degenerieren können
Ein binärer Suchbaum (BST) versucht, die Vorteile zweier Welten zu vereinen: die schnelle Suchfähigkeit eines sortierten Arrays und die dynamische Größenanpassung einer verketteten Liste. Es handelt sich um einen Baum aus Knoten, wobei jeder Knoten bis zu zwei Kinder haben kann. Die Struktur wird durch die „Eigenschaft der binären Suche“ bestimmt: Für jeden Knoten sind alle Werte in seinem linken Teilbaum kleiner und alle Werte in seinem rechten Teilbaum größer.
Diese Eigenschaft ermöglicht eine binäre Suche durch einfaches Verfolgen der linken oder rechten Zeiger im Baum und erreicht so im Durchschnitt eine effiziente logarithmische Suchzeit (O(log n)) . Der binäre Suchbaum (BST) hat jedoch einen entscheidenden Nachteil: Im „perversen Fall“, in dem bereits sortierte Daten eingefügt werden (z. B. 1, dann 2, dann 3, dann 4), wird der Baum völlig unausgewogen. Jeder neue Knoten wird einfach rechts neben dem vorherigen eingefügt.
Im schlimmsten Fall „degeneriert der binäre Suchbaum zu einer verketteten Liste“. Seine Suchleistung verschlechtert sich von logarithmischer Zeit auf langsame, linear time (O(n)).
Verbindung zur Datenwissenschaft
Der unausgeglichene binäre Suchbaum (BST) ist eine aussagekräftige Metapher für den Unterschied zwischen durchschnittlicher und maximaler Leistung. In der Datenwissenschaft können die Verteilung und Reihenfolge der Eingabedaten die Effizienz eines Algorithmus erheblich beeinflussen. Daher benötigen Datenbankindizes, die häufig auf Baumstrukturen basieren, komplexe Ausgleichsalgorithmen, um sich kontinuierlich neu zu organisieren und dieses Worst-Case-Szenario zu verhindern.
5. Hashtabellen: Der praktische Weg zu konstanter Zeit
Die Hashtabelle ist die bevorzugte Datenstruktur zur Implementierung von Wörterbüchern, die Schlüssel-Wert-Paare speichern. Sie kombiniert auf raffinierte Weise Arrays und verkettete Listen, um nahezu sofortige Zugriffe zu ermöglichen. Ihre Kernkomponenten sind:
- Ein Array von „Eimern“.
- A Hash-Funktion Das System nimmt einen Schlüssel (z. B. den Namen einer Person) und wandelt ihn deterministisch in einen Index für das Array um.
- Verknüpfte Listen innerhalb jedes Buckets, um „Kollisionen“ zu behandeln – Fälle, in denen zwei verschiedene Schlüssel auf denselben Array-Index gehasht werden.
Die Analogie der Abholregale bei Sweetgreen aus der Vorlesung veranschaulicht dies perfekt. Ihr Name auf der Bestellung ist der Schlüssel. Der Mitarbeiter, der anhand des Anfangsbuchstabens Ihres Namens ein Regal auswählt (AE, FJ usw.), ist die Hash-Funktion. Das Regal selbst ist der Bucket (ein Index im Array). Die wenigen Salate in diesem Regal, die Sie durchsuchen müssen, repräsentieren die verkettete Liste zur Kollisionsbehandlung. Während der theoretische Worst Case linear time (O(n)) ist , falls alle Schlüssel zu einer langen verketteten Liste kollidieren, liegt die praktische, durchschnittliche Laufzeit bemerkenswert nahe an konstante Zeit (O(1)).
„Ja, Hashtabellen haben technisch gesehen eine Komplexität von N geteilt durch K, was im Grunde O(n) entspricht. Aber in der Praxis, wenn man klug vorgeht und eine geeignete Hashfunktion verwendet, ist die Kollisionswahrscheinlichkeit wahrscheinlich so gering, dass die Laufzeit selbst bei gelegentlichen linearen Schwankungen meist konstant ist, also O(1) entspricht.“ – Harvard CS50x 2025 (YouTube) – Vorlesung: Datenstrukturen
Verbindung zur Datenwissenschaft
Hashtabellen sind die Grundlage für Pythons Wörterbücher (dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
Was Sie heute bewerben sollten
- Für Schlüssel-Wert-Abfragen ist stets ein Wörterbuch/eine Hash-Map vorzuziehen. gegenüber dem Durchsuchen einer Liste von Paaren. Der Leistungsunterschied zwischen O(1) und O(n) ist bei großen Datensätzen enorm.
- Achten Sie auf die Datenreihenfolge, wenn es auf die Leistung ankommt. Wie man bei binären Suchbäumen sieht, kann das Einfügen sortierter Daten in bestimmte Strukturen zu einem Worst-Case-Verhalten führen.
- Überlegen Sie, ob Ihre Daten geordnet werden müssen. Wenn Sie nur schnelle Suchvorgänge und Mitgliedschaftsprüfungen benötigen, ist ein Set (hashbasiert) weitaus effizienter als eine Liste.
- Visualisieren Sie die zugrunde liegenden Operationen. Wenn ein Skript langsam ist, sollten Sie darüber nachdenken, ob Sie innerhalb einer Schleife eine lineare O(n)-Operation erzwingen und dadurch unbeabsichtigt eine Komplexität von O(n²) erzeugen.
- Den Zeit-Raum-Kompromiss erkennen. Eine Hashtabelle (wie eine Python-
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
Schließen
Das zentrale Thema ist, dass jede Datenstruktur einen Kompromiss zwischen Zeitaufwand, Speicherplatzbedarf und Implementierungskomplexität darstellt. Es gibt keine „beste“ Struktur, sondern nur die jeweils geeignetste für die jeweilige Aufgabe. Im Anschluss daran geht es um Python, eine Sprache, die viele der besprochenen Details der manuellen Speicherverwaltung abstrahiert. Die Leistungsprinzipien bleiben jedoch genauso wichtig, da diese Strukturen weiterhin im Hintergrund arbeiten. Welche Ihrer täglich verwendeten Datenstrukturen werden Sie nun anders betrachten?



